KI in der Webentwicklung: DSGVO, AI Act und Compliance technisch kontrolliert umsetzen
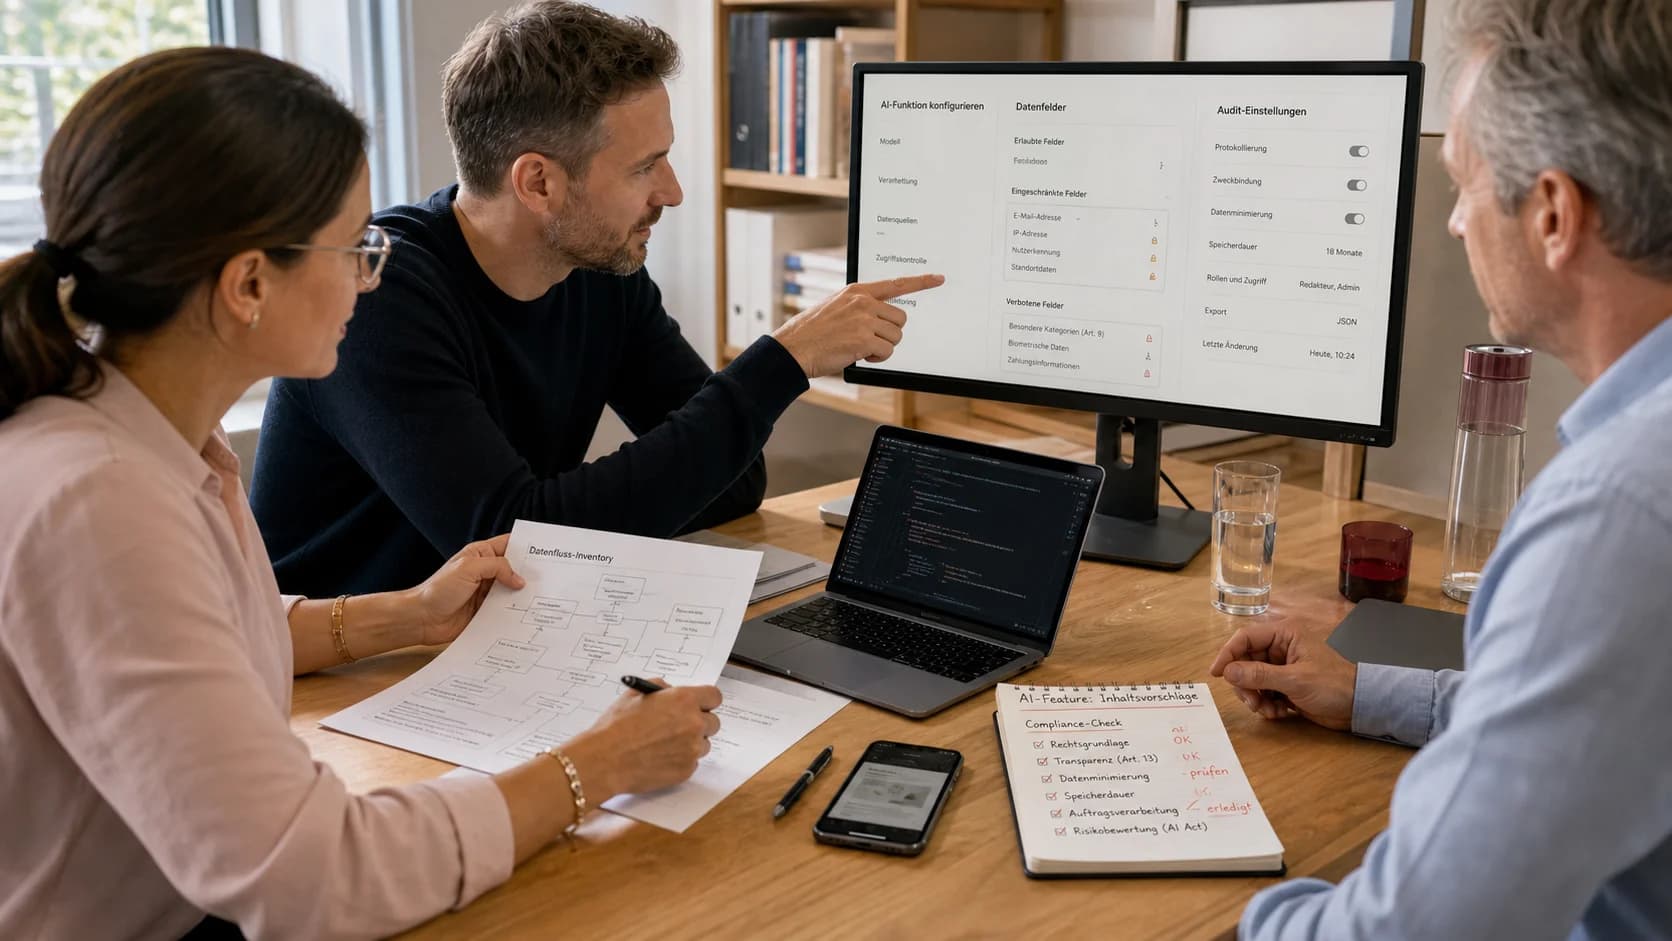

KI Webentwicklung und DSGVO: Datenflüsse, Anbieter, AI Act, Rechte, Sicherheit, Protokolle und Freigaben für Webprojekte kontrollieren.
KI in der Webentwicklung: DSGVO, AI Act und Compliance technisch kontrolliert umsetzen
Ein Entwickler kopiert einen Produktionsfehler samt Kundendatensatz in einen KI-Chat. Ein Redaktionsteam lädt vertrauliche Unterlagen für einen Entwurf hoch. Ein Website-Assistent speichert Gespräche, obwohl niemand Aufbewahrung und Löschung festgelegt hat. In allen Fällen liegt das Problem vor der Modellantwort.
KI in der Webentwicklung und DSGVO müssen als Daten-, Rollen- und Betriebsprozess geplant werden. Der AI Act ergänzt je nach Rolle und Einsatz weitere Pflichten. Dieser Beitrag liefert technische und organisatorische Orientierung; die rechtliche Bewertung des konkreten Falls übernehmen die zuständigen Fachstellen.
KI Webentwicklung und DSGVO beginnen mit einem vollständigen Einsatzinventar
Erfasst werden Code-Assistenten, Chatbots, Bildgeneratoren, Übersetzung, Analyse, Tests und eigene Modellintegrationen. Browsererweiterungen und Funktionen in bereits lizenzierten Plattformen gehören ebenfalls dazu.
Für jeden Einsatz stehen Anbieter, Modell, Kontotyp, Nutzer, Datenkategorien, Zweck und Zielsystem fest. Eine pauschale Position „Wir nutzen ChatGPT“ reicht für die Bewertung nicht.
Das Inventar besitzt Verantwortlichen und Prüftermin. Neue Funktionen können Datenwege verändern, ohne dass ein neues Tool beschafft wird.
Die Rolle des Unternehmens wird pro Datenverarbeitung bestimmt
Je nach Gestaltung kann das Unternehmen Verantwortlicher, gemeinsam Verantwortlicher, Auftragsverarbeiter oder Nutzer eines Dienstes sein. Marketingbegriffe des Anbieters legen diese Rolle nicht abschließend fest.
Entscheidend ist, wer Zwecke und Mittel der Verarbeitung bestimmt und welche Weisungen bestehen. Bei einer kundenspezifischen Lösung können mehrere Beziehungen nebeneinander auftreten.
Vertrag, technische Architektur und tatsächliche Nutzung müssen zusammenpassen. Die zuständigen Datenschutzrollen dokumentieren die Bewertung.
Zweck und Rechtsgrundlage werden vor dem ersten produktiven Datensatz geklärt
Codegenerierung ohne personenbezogene Eingaben besitzt ein anderes Profil als ein Supportbot mit Kundenhistorie. Jeder Zweck wird konkret beschrieben und gegen eine geeignete Rechtsgrundlage geprüft.
Eine Einwilligung ist nicht automatisch die beste oder einzige Lösung. Sie muss freiwillig, informiert und widerrufbar sein. Andere Rechtsgrundlagen benötigen ebenfalls ihre Voraussetzungen und Abwägung.
Der EDSA behandelt in seiner Stellungnahme zu KI-Modellen unter anderem die fallbezogene Prüfung berechtigter Interessen. Eine allgemeine KI-Nützlichkeit ersetzt diese Prüfung nicht.
Datenminimierung beginnt am Prompt und nicht erst bei der Speicherung
Für einen Codefehler genügen häufig Stacktrace, synthetische Eingaben und betroffene Funktion. Name, E-Mail oder vollständiger Produktionsdatensatz werden entfernt.
Promptvorlagen und technische Filter unterstützen Entwickler. Sie dürfen nicht den Eindruck erwecken, jedes Geheimnis zuverlässig zu erkennen.
Wo möglich, werden Platzhalter und künstliche Beispiele verwendet. Der verantwortliche Nutzer prüft vor dem Senden, ob der Kontext tatsächlich notwendig ist.
Besondere Kategorien personenbezogener Daten erhalten enge Grenzen
Gesundheit, biometrische Daten und andere besonders geschützte Kategorien können in Formularen, Supportfällen oder Branchensoftware vorkommen. Ihre Verarbeitung verlangt eine gesonderte rechtliche und technische Bewertung.
Ein allgemeiner KI-Assistent erhält solche Daten nicht aus Bequemlichkeit. Test- und Entwicklungsumgebungen verwenden reduzierte oder synthetische Datensätze.
Notwendige produktive Verarbeitung wird durch Rollen, Verschlüsselung, Protokollierung und kurze Aufbewahrung begrenzt. Modelltraining und Analysezwecke werden getrennt betrachtet.
Anbieterprüfung umfasst Vertrag, Unterauftragnehmer und Produktmodus
Geprüft werden Leistungsbeschreibung, Auftragsverarbeitung, Speicherorte, Unterauftragnehmer, Löschung, Sicherheitsmaßnahmen und Nutzung von Eingaben zur Modellverbesserung.
Kostenlose, persönliche und geschäftliche Konten können unterschiedliche Bedingungen besitzen. Die freigegebene Produktvariante wird deshalb technisch und organisatorisch festgelegt.
Ändert der Anbieter Funktionen oder Vertragsbedingungen, folgt eine erneute Bewertung. Ein einmal abgelegtes PDF beendet die Lieferantenkontrolle nicht.
Internationale Übermittlungen werden entlang aller Empfänger geprüft
Firmenadresse und Serverregion des Hauptanbieters zeigen nicht automatisch den vollständigen Datenweg. Support, Sicherheit, Unterauftragnehmer und Telemetrie können weitere Empfänger einbeziehen.
Die zuständigen Stellen prüfen Übermittlungsgrundlage, zusätzliche Maßnahmen und tatsächliche Zugriffsmöglichkeiten. Technische Verschlüsselung schützt Transport und Speicher, verhindert aber nicht jeden autorisierten Anbieterzugriff.
Regionale Verarbeitung wird vertraglich und technisch konfiguriert. Sie wird nicht nur aus einer Marketingseite abgeleitet.
Training, Modellverbesserung und Protokollanalyse bleiben getrennte Zwecke
Ein Dienst kann Eingaben zur Bereitstellung, Missbrauchserkennung, Support oder Verbesserung verarbeiten. Diese Zwecke besitzen unterschiedliche Umfangs- und Aufbewahrungsfolgen.
Opt-out- oder Zero-Retention-Einstellungen werden dokumentiert und regelmäßig geprüft. Sie gelten möglicherweise nicht für alle Funktionen oder Fehlerberichte.
Eigene Evaluationen verwenden bewusst ausgewählte Datensätze. Kundendialoge werden nicht pauschal zum Trainingsbestand, nur weil sie bereits gespeichert sind.
Der EDSA verlangt bei Anonymität eine fallbezogene Bewertung
Ein Modell ist nicht automatisch anonym, nur weil kein Name in einer Oberfläche sichtbar ist. Der Europäische Datenschutzausschuss nennt als relevante Fragen unter anderem, wie wahrscheinlich Identifizierung oder Extraktion personenbezogener Trainingsdaten ist.
Diese Bewertung hängt von Modell, Daten, Zugriff und Schutzmaßnahmen ab. Pseudonymisierung reduziert Risiken, bleibt aber personenbezogene Verarbeitung.
Unternehmen verlassen sich deshalb nicht auf eine pauschale Anbieterbehauptung. Für den eigenen Einsatz wird geprüft, welche Daten das Modell oder System tatsächlich verarbeitet und ausgeben kann.
Datenschutz-Folgenabschätzung wird anhand des konkreten Risikos geprüft
Neue Technologie, umfangreiche Überwachung, sensible Daten oder systematische Bewertung können eine Datenschutz-Folgenabschätzung erforderlich machen. Die zuständigen Stellen prüfen die Kriterien des konkreten Einsatzes.
Website-Qualitäts-Check
Wie gut ist Ihre Website wirklich? Technik, SEO & Conversion im Check.
- Qualitäts-Score 0–100
- Stärken und Schwachstellen
- Konkrete Verbesserungen
- Bericht per E-Mail
Technik liefert Systembeschreibung, Datenflüsse, Empfänger, Aufbewahrung, Berechtigungen und geplante Kontrollen. Risiken für betroffene Personen stehen im Mittelpunkt, nicht nur Unternehmensschäden.
Die Prüfung erfolgt vor dem produktiven Rollout und wird bei wesentlichen Änderungen aktualisiert. Ein später nachgereichtes Dokument kann Architekturentscheidungen kaum noch beeinflussen.
Automatisierte Entscheidungen werden von Assistenzfunktionen getrennt
Ein Modell kann Inhalte vorschlagen, Anfragen priorisieren oder Entscheidungen vorbereiten. Je stärker das Ergebnis Menschen rechtlich oder ähnlich erheblich betrifft, desto genauer werden Rechtsgrundlage, Transparenz und menschliche Kontrolle geprüft.
Ein formaler Klick auf „Freigeben“ genügt nicht, wenn Mitarbeiter das Ergebnis praktisch nie hinterfragen können. Sie benötigen Kontext, Kompetenz und echte Entscheidungsmöglichkeit.
Verbindliche Ablehnung, Preis oder Leistungszugang werden nicht unbemerkt aus einer intransparenten Modellbewertung erzeugt. Die zuständigen Rechtsrollen prüfen insbesondere die Anforderungen der DSGVO an automatisierte Entscheidungen.
Der AI Act ergänzt die DSGVO mit einem eigenen Rollen- und Risikomodell
Der AI Act unterscheidet unter anderem Anbieter und Betreiber sowie verbotene, hochriskante und transparenzpflichtige Einsatzfälle. Dieselbe technische Komponente kann je nach Zweck unterschiedlich eingeordnet werden.
Die DSGVO bleibt daneben anwendbar, sobald personenbezogene Daten verarbeitet werden. Eine AI-Act-Einstufung ersetzt keine Datenschutzprüfung.
Die aktuelle EU-Kommissionsübersicht wird für Zeitplan und Pflichten herangezogen. Wegen laufender Konkretisierung und besonderer Übergangsregeln wird die Einordnung vor jedem relevanten Rollout erneut geprüft.
Seit Februar 2025 gehört KI-Kompetenz zu den ausdrücklich anwendbaren Anforderungen
Die EU-Kommission führt die Bestimmungen zur KI-Kompetenz seit dem 2. Februar 2025 als anwendbar. Unternehmen planen daher angemessene Kenntnisse für Personen, die KI-Systeme betreiben oder deren Ergebnisse verwenden.
Schulung richtet sich nach Rolle und Risiko. Ein Redakteur braucht andere Kompetenzen als ein Entwickler, der Modellwerkzeuge mit Kundensystemen verbindet.
Dokumentiert werden Inhalte, Zielgruppen und Aktualisierung. Eine einmalige allgemeine Präsentation ersetzt keine arbeitsplatzbezogenen Regeln.
Transparenz wird in Oberfläche und Prozess passend umgesetzt
Nutzer sollten erkennen, wenn sie mit einem KI-System interagieren, soweit dies rechtlich und für die Entscheidung erforderlich ist. Hinweise erklären Betreiber, Zweck, Datenverarbeitung und menschliche Alternative verständlich.
Ein langer Rechtstext im ausgeblendeten Menü ersetzt keine kontextgerechte Information. Gleichzeitig wird die Oberfläche nicht mit technisch irrelevanten Modellnamen überladen.
Generierte oder manipulierte Medien können zusätzliche Kennzeichnungsfragen auslösen. Inhalt, Kanal und geltende Pflichten werden konkret bewertet.
Betroffenenrechte benötigen einen durchgängigen Bearbeitungsweg
Auskunft, Berichtigung, Löschung, Einschränkung und Widerspruch können Daten in Chatprotokollen, CRM, Vektorspeicher und Analyse betreffen. Das Unternehmen muss betroffene Datensätze finden und Zuständigkeiten kennen.
Eindeutige IDs, Aufbewahrung und Empfängerliste unterstützen die Bearbeitung. Ein Modell wird nicht angewiesen, die rechtliche Entscheidung selbst zu treffen.
Wenn eine Löschung technisch oder rechtlich begrenzt ist, dokumentieren die zuständigen Stellen den konkreten Umgang. Eine pauschale Behauptung, KI-Daten seien nicht löschbar, reicht nicht.
Aufbewahrung folgt Zweck, System und Nachweispflicht
Promptprotokolle, Chatverläufe, generierte Dateien und Sicherheitslogs müssen nicht dieselbe Frist besitzen. Für jeden Speicher steht Zweck und Löschmechanismus fest.
Produktive Daten werden nicht dauerhaft behalten, nur weil Speicher günstig ist. Zu kurze Fristen können andererseits Support und Nachweis verhindern.
Löschläufe werden getestet. Auch Exporte, Backups und nachgelagerte Systeme gehören in das Konzept, ohne eine sofortige Löschung aus technisch notwendigen Sicherungen pauschal zu versprechen.
Berechtigungen begrenzen Modelle, Quellen und Aktionen
Entwickler, Redakteure und Support erhalten unterschiedliche KI-Funktionen. Ein öffentliches Chatfenster darf keine internen Dokumente oder Administrationsaktionen erreichen.
Technische Identitäten besitzen minimale Scopes. Besonders sensible Funktionen verlangen zusätzliche Freigabe oder bleiben vollständig außerhalb des Modellzugriffs.
Rechte werden bei Rollenwechsel und Projektende entzogen. Gemeinsame API-Schlüssel verhindern Nachvollziehbarkeit und erhöhen das Schadenspotenzial.
Prompt Injection und Datenabfluss werden im Sicherheitskonzept berücksichtigt
Angreifer können Eingaben oder eingebundene Dokumente so formulieren, dass das Modell interne Anweisungen ignorieren oder vertrauliche Informationen ausgeben soll. Die technische Website-Sicherheit ergänzt Konten, Geheimnisse, Monitoring und Vorfallreaktion.
OWASP beschreibt Prompt Injection und unsichere Ausgabeverarbeitung als zentrale Risiken von LLM-Anwendungen. Schutz entsteht durch getrennte Vertrauenszonen, begrenzte Werkzeuge, Autorisierung und Validierung.
Ein Warnsatz im Systemprompt ist keine ausreichende Kontrolle. Das Backend entscheidet unabhängig vom Modell, welche Daten und Aktionen zulässig sind.
Geheimnisse und produktiver Code erhalten einen kontrollierten KI-Kontext
Repositories können Zugangsdaten, interne Endpunkte und proprietäre Logik enthalten. Code-Assistenten erhalten nur den für die Aufgabe erlaubten Kontext.
Secret-Scanning, Zugriffskontrolle und getrennte Umgebungen ergänzen die Nutzerregel. Ein versehentlich gesendeter Schlüssel wird rotiert und nicht nur aus dem Chat gelöscht.
Bei besonders schutzbedürftigem Code kann ein anderer Betriebsmodus oder der Verzicht auf externe Modellverarbeitung sinnvoll sein. Diese Entscheidung folgt Schutzbedarf und Anbieterprüfung.
KI-Ausgaben bleiben nicht vertrauenswürdige Eingaben für nachgelagerte Systeme
Generierter Code, SQL, HTML und Konfiguration werden geprüft, getestet und sicher ausgeführt. Modelltext wird nicht direkt als Befehl oder Datenbankabfrage übernommen.
Strukturierte Antworten erhalten Schema, erlaubte Werte und fachliche Validierung. Eine plausible Ausgabe kann trotzdem falsch oder manipuliert sein.
Die KI-gestützte Testautomatisierung unterstützt Regressionen. Code-Review und verantwortliche Freigabe bleiben bestehen.
Urheberrecht, Lizenzen und Geschäftsgeheimnisse werden separat geprüft
Datenschutz beantwortet nicht, ob Trainingsmaterial, Referenzbild oder generierter Code lizenzrechtlich verwendet werden darf. Anbieterbedingungen und Projektlizenzen werden deshalb zusätzlich betrachtet.
KI-Ausgaben werden auf auffällige Übernahmen, Marken und bekannte Bestandteile geprüft. Bei Code bleiben Open-Source-Lizenzen und Notices relevant.
Vertrauliche Kundeninformationen können Geschäftsgeheimnisse sein, auch wenn sie keine personenbezogenen Daten enthalten. Freigaberegeln schützen beide Kategorien.
Open-Source-Modelle verlagern Verantwortung statt sie zu beseitigen
Ein lokal betriebenes Modell kann Datenflüsse begrenzen. Das Unternehmen übernimmt dafür Hosting, Updates, Zugriff, Logging und Sicherheitsbetrieb.
Modelllizenz, Herkunft, Trainingsdokumentation und bekannte Grenzen werden geprüft. „Open Source“ bedeutet weder automatisch frei von Pflichten noch automatisch transparent.
Der Vergleich berücksichtigt Gesamtbetrieb und erforderliche Qualität. Für einen begrenzten Anwendungsfall kann ein externer Dienst trotz Anbieterprüfung wirtschaftlicher und kontrollierbarer sein.
Entwicklungs-, Test- und Produktionsdaten bleiben getrennt
Entwürfe und Tests verwenden synthetische Daten und eigene Schlüssel. Produktive Prompts oder Protokolle gelangen nur bei begründetem Bedarf in eine Analyseumgebung. Eine kontrollierte API-Integration verhindert, dass Modellzugriffe die Rechte des Zielsystems umgehen.
Testkonten dürfen keine echten Kundenaktionen auslösen. Modell- und Promptversionen werden zwischen Umgebungen kontrolliert übertragen.
Die technischen Anforderungen an DSGVO-konforme Websites ergänzen Formulare, Hosting und Drittanbieter. Ein KI-Baustein wird nicht isoliert vom restlichen Datenweg bewertet.
Protokollierung schafft Nachvollziehbarkeit ohne neue Datensammlung
Für kritische Aktionen werden Modellversion, Eingabeart, verwendete Quelle, Funktionsaufruf und Ergebnisstatus nachvollziehbar. Nicht jeder vollständige Inhalt muss im Log stehen.
Passwörter, Tokens und unnötige personenbezogene Daten werden gefiltert. Zugriffe auf Protokolle sind beschränkt und überwacht.
Die Daten helfen bei Fehleranalyse, Betroffenenanfragen und Sicherheitsvorfällen. Ein umfassendes Log ohne definierten Zweck und Löschfrist schafft selbst ein Risiko.
Vorfallreaktion umfasst Anbieter, Modell und verbundene Systeme
Ein Vorfall kann Datenabfluss, unerlaubte Aktion, falsche Auskunft oder kompromittierten Schlüssel betreffen. Für jede Klasse stehen Eindämmung, Ansprechpartner und Beweissicherung fest.
Anbieterkommunikation und vertragliche Meldewege werden vorab dokumentiert. Technik liefert betroffene Daten, Zeitraum und Zugriff; zuständige Stellen bewerten Informations- und Meldepflichten.
Nach der Behebung werden Prompt, Rechte, Tests und Schulung angepasst. Ein einzelnes Gespräch zu löschen, ohne die Eintrittsstelle zu schließen, beendet den Vorfall nicht.
Ein Freigabegate verbindet Datenschutz, Sicherheit und Fachverantwortung
Vor dem Produktivstart liegen Einsatzbeschreibung, Datenfluss, Anbieterprüfung, Rechte, Tests, Aufbewahrung und Notbetrieb vor. Offene Punkte erhalten Eigentümer und Termin. Bei einem Assistenten umfasst das auch die sichere Chatbot-Integration mit Quellen, Übergabe und begrenzten Aktionen.
Fachbereich bestätigt erlaubte Aussagen und Aktionen. Datenschutz und Informationssicherheit bewerten ihre jeweiligen Anforderungen. Technik weist die implementierten Kontrollen nach.
Die Freigabe gilt für einen definierten Umfang. Eine spätere Verbindung mit CRM oder vertraulicher Wissensbasis kann eine neue Bewertung auslösen.
Laufende Kontrolle reagiert auf Modell-, Anbieter- und Rechtsänderungen
Modelle und Produktfunktionen ändern sich schneller als klassische Softwareversionen. Qualitätstests und Datenschutzinventar werden bei wesentlichen Änderungen aktualisiert. Die professionelle KI-Webentwicklung behandelt Modell- und Promptwechsel deshalb wie kontrollierte Releases.
Die EU-Kommission, Datenschutzbehörden und Anbieter veröffentlichen neue Leitlinien. Ein Verantwortlicher beobachtet relevante Quellen und übersetzt sie in konkrete Aufgaben.
Compliance bleibt damit ein Betriebsprozess. Ein einmaliger KI-Fragebogen vor dem Pilot reicht für eine dauerhaft integrierte Webanwendung nicht.
SW Business Solutions baut KI-Weblösungen mit kontrollierten Daten- und Betriebswegen
SW Business Solutions verbindet technische Architektur, Datenschutzanforderungen, Sicherheitstests und fachliche Freigaben. Wir integrieren geeignete KI-Dienste oder entwickeln eine zugeschnittene Lösung mit begrenzten Quellen und Aktionen.
Die konkrete rechtliche Bewertung verbleibt bei Ihren zuständigen Datenschutz- und Rechtsstellen. Wir liefern dafür Systeminventar, Datenfluss, Konfiguration, Protokollierung und nachweisbare technische Maßnahmen.
Eine technische KI- und Datenschutzanalyse anfragen beginnt mit einem konkreten Einsatzfall und den vorgesehenen Daten. Das Ergebnis ist eine umsetzbare Maßnahmenliste statt eines pauschalen Freigabeversprechens.