KI-Code-Assistent für Webentwicklung im Vergleich: GitHub Copilot, Cursor und weitere Werkzeuge

KI-Code-Assistenten für Webentwicklung anhand von Kontext, Datenschutz, Review, Agenten, Kosten und Teamsteuerung vergleichen und sicher einführen.
KI-Code-Assistent für Webentwicklung im Vergleich: GitHub Copilot, Cursor und weitere Werkzeuge
Zwei Entwickler können denselben KI-Code-Assistenten nutzen und völlig unterschiedliche Ergebnisse erzielen. Einer lässt eine kleine Funktion mit Tests vorbereiten, der andere übergibt einen unklaren Auftrag an einen Agenten mit breitem Repository-Zugriff. Das Produkt ist identisch, Arbeitsprozess und Risiko sind es nicht. Ein KI Code-Assistent für Webentwicklung muss deshalb im realen Teamablauf verglichen werden.
GitHub Copilot, Cursor und weitere Werkzeuge verändern Funktionen, Modelle und Tarife laufend. Eine statische Siegerliste wäre schnell veraltet. Belastbarer ist ein Kriterienvergleich: Welcher Kontext wird benötigt, welche Daten verlassen das Unternehmen, wie werden Änderungen geprüft und lässt sich der Nutzen vollständig bis zum freigegebenen Code messen?
Ein KI Code-Assistent für Webentwicklung wird an Aufgabenklassen getestet
Codevervollständigung, Chat, Repository-Analyse, Agenten und Code-Review sind unterschiedliche Aufgaben. Ein Werkzeug kann bei kleinen Ergänzungen überzeugen und bei einer mehrteiligen Migration unzuverlässig sein.
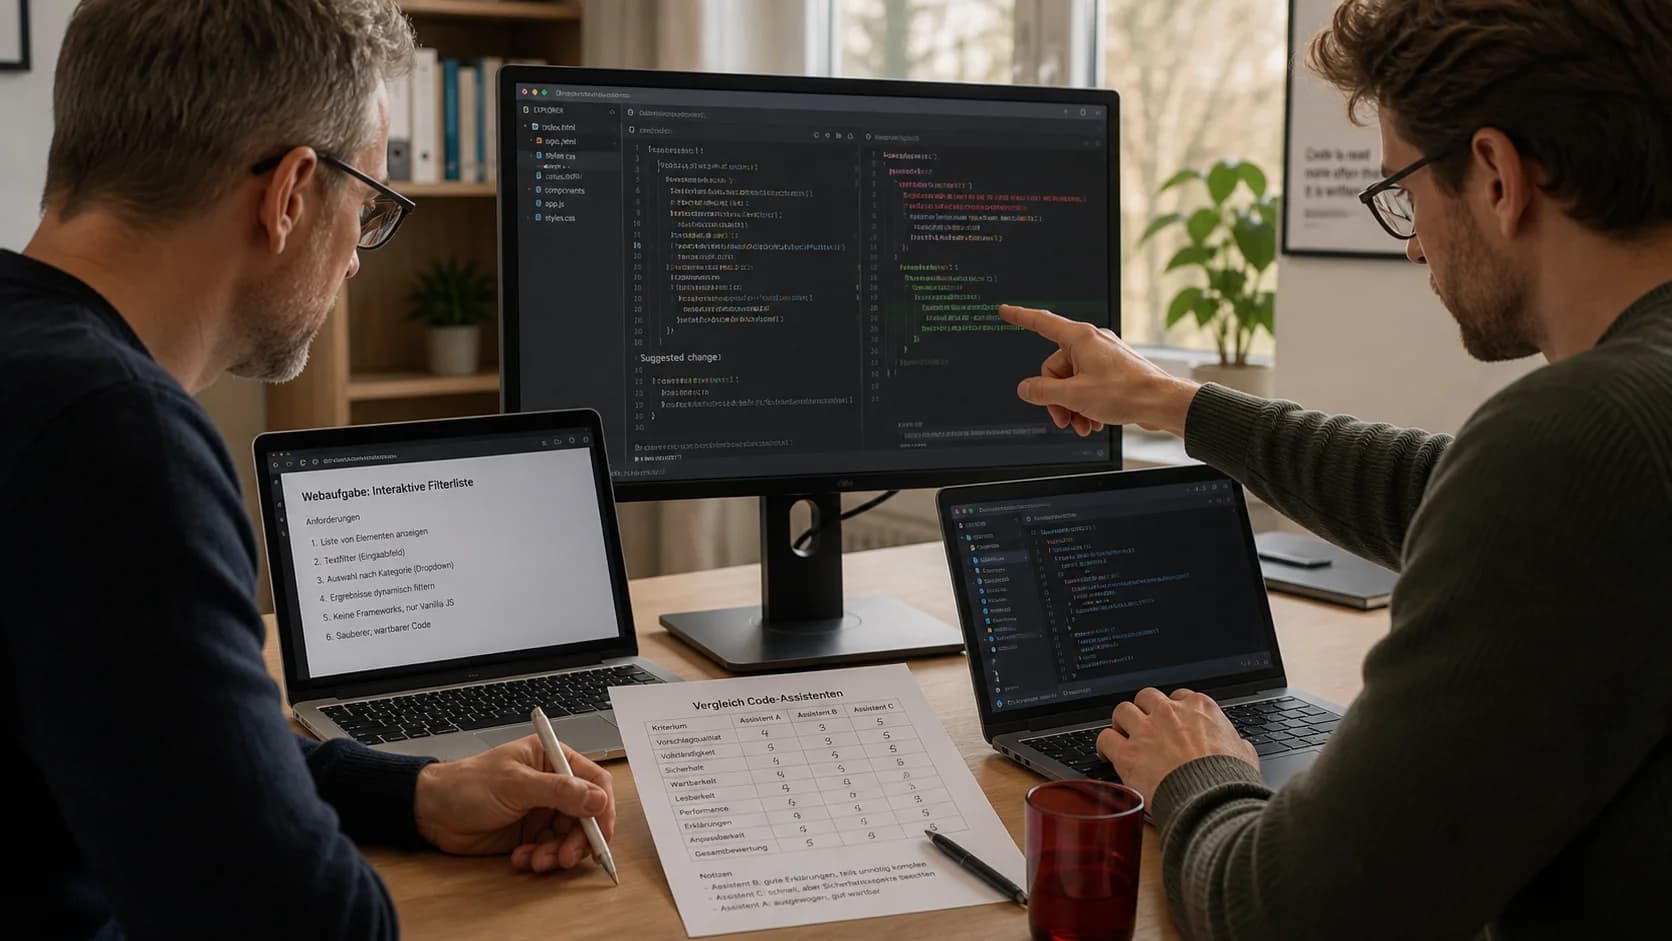
Das Team definiert vor dem Test typische Klassen: vorhandenen Code erklären, Bug reproduzieren, Komponente ergänzen, Tests schreiben, Abhängigkeit aktualisieren und Pull Request prüfen. Für jede Aufgabe stehen Ausgangscode, erwartetes Ergebnis und Qualitätskontrollen fest.
So entsteht kein Vergleich nach Demo-Eindruck. Die Bewertung zeigt, in welchem Teil des eigenen Entwicklungsprozesses das Werkzeug tatsächlich hilft.
GitHub Copilot ist eng mit Repository- und Pull-Request-Abläufen verbunden
GitHub dokumentiert Copilot-Funktionen in IDE, Kommandozeile, GitHub-Oberfläche und agentischen Arbeitsweisen. Welche Funktionen, Richtlinien und Modelle verfügbar sind, hängt vom aktuellen Plan und der jeweiligen Oberfläche ab.
Für Teams kann die Nähe zu Repository, Pull Requests und Richtlinien ein Vorteil sein. Gleichzeitig wird genau geprüft, welche Inhalte ein Agent lesen, welche Befehle er ausführen und wie ein Review in bestehende Freigaben eingebunden wird.
GitHub weist in der eigenen Dokumentation darauf hin, dass KI-Ergebnisse überprüft und getestet werden müssen. Ein Copilot-Review ersetzt keine vorgeschriebene menschliche Freigabe.
Cursor verbindet Editor und agentische Arbeit in einer eigenen Umgebung
Cursor beschreibt sich aktuell als Coding Agent, der Codebasen verstehen, Änderungen planen, Fehler beheben und Diffs prüfen kann. Die Dokumentation zeigt neben Editorfunktionen auch Cloud-Agenten, Regeln, Skills, MCP und Integrationen.
Der Vorteil einer tief integrierten Umgebung muss gegen Einführung, Richtlinien und Datenzugriff abgewogen werden. Teams prüfen, ob bestehende Editor- und Sicherheitsstandards erhalten bleiben und wie Agentänderungen nachvollziehbar überprüft werden.
Da Modelle und Funktionen schnell wechseln, werden konkrete Fähigkeiten nur aus der aktuellen offiziellen Dokumentation und einem Pilot abgeleitet. Ein früherer Produktvergleich ist keine dauerhafte Beschaffungsgrundlage.
Weitere Werkzeuge werden nach demselben Raster bewertet
IDE-Erweiterungen, terminalbasierte Agenten und eigenständige Entwicklungsumgebungen können ähnliche Aufgaben anbieten. Produktnamen allein sagen wenig darüber aus, wie viel Kontext, Kontrolle und Integration ein Team erhält.
Jeder Kandidat wird mit denselben Repositories, Aufgaben und Qualitätskriterien getestet. Unterschiede in Modell, Geschwindigkeit oder Oberfläche werden nicht mit Ergebnisqualität verwechselt.
Ein Werkzeug kann als Ergänzung geeignet sein, ohne unternehmensweiter Standard zu werden. Spezialisierte Nutzung bleibt möglich, sofern Daten- und Freigaberegeln eingehalten werden.
Kontextzugriff ist zugleich Nutzenquelle und Risiko
Ein Assistent liefert passendere Vorschläge, wenn er Architektur, Konventionen und verwandte Dateien kennt. Breiter Kontext kann jedoch vertrauliche Logik, Kundendaten oder Geheimnisse einschließen.
Das Team klassifiziert Repositories und Verzeichnisse. Zugangsschlüssel, Produktionsdaten und besonders schützenswerte Projekte werden ausgeschlossen oder in geeigneten Umgebungen bearbeitet. Inhaltsausschluss und Richtlinien werden praktisch getestet, nicht nur aktiviert.
Projektwissen bleibt in versionierten Regeln, Dokumentation und Tests. Private Chatverläufe dürfen nicht zur einzigen Quelle wichtiger Architekturentscheidungen werden.
Datenschutz und Vertragsbedingungen werden vor dem Repository-Zugriff geprüft
Relevant sind übertragene Inhalte, Speicher- und Trainingsregeln, Unterauftragnehmer, Regionen, Protokollierung und Administrationsmöglichkeiten. Die konkrete rechtliche Bewertung übernehmen die zuständigen Stellen.
Technik dokumentiert, welche Oberfläche welche Daten erhält. Ein IDE-Chat, Cloud-Agent und externer MCP-Dienst können unterschiedliche Wege besitzen. Eine allgemeine Freigabe für den Produktnamen ist daher möglicherweise zu grob.
Der geplante Beitrag Datenschutz bei KI in der Webentwicklung vertieft diese Fragen. Änderungen an Anbieterbedingungen lösen eine erneute Prüfung aus.
Modelle und automatische Auswahl erschweren statische Bestenlisten
Ein Produkt kann mehrere Modelle oder automatische Auswahl anbieten. Qualität, Geschwindigkeit, Kontext und Kosten verändern sich dadurch. Ein Ergebnis aus einem einzelnen Modelltest lässt sich nicht pauschal auf den gesamten Dienst übertragen.
Für kritische Aufgaben wird die verwendete Konfiguration dokumentiert. Tests berücksichtigen, ob ein Modellwechsel kontrollierbar ist und ob das Unternehmen bestimmte Modelle sperren oder freigeben kann.
Die Beschaffung bewertet den Arbeitsprozess, nicht nur eine Rangliste. Gute Tests und Review bleiben auch nach einem Modellupdate gültige Schutzmechanismen.
Agenten benötigen engere Rechte als ein interaktiver Vorschlag
Eine Codevervollständigung schlägt Text vor, den ein Entwickler unmittelbar sieht. Ein Agent kann Dateien ändern, Befehle ausführen oder externe Systeme nutzen. Mit wachsender Handlungsmacht steigen Anforderungen an Umgebung und Freigabe.
Agenten arbeiten in begrenzten Branches oder Sandboxes, erhalten nur notwendige Geheimnisse und dürfen kritische Aktionen nicht ungeprüft ausführen. Netzwerkzugriff und externe Tools werden bewusst freigegeben.
Jede Änderung bleibt als Diff sichtbar. Tests und menschliches Review stehen vor Merge und Deployment. Autonomie wird nach Fehlerfolge statt nach technischer Möglichkeit gewählt.
Codequalität wird bis zum Merge statt bis zur ersten Antwort gemessen
Ein Assistent kann in Sekunden hundert Zeilen erzeugen, deren Korrektur eine Stunde dauert. Deshalb zählt vollständige Durchlaufzeit aus Auftrag, Generierung, Review, Tests, Nacharbeit und Dokumentation.
Checkliste: Bereit für individuelle Software?
Persönliche PDF-Checkliste: Wann sich Individualsoftware lohnt und worauf Sie achten sollten.
Zusätzlich werden Fehler nach Release, Rückfragen im Review und Verständlichkeit des Codes betrachtet. Eine hohe Akzeptanzrate von Vorschlägen ist kein Qualitätsbeweis, wenn Entwickler Änderungen ungeprüft übernehmen.
Der Leitfaden zum professionellen KI-Einsatz in der Webentwicklung erklärt die übergeordneten Kontrollen. Der Produktvergleich nutzt dieselben Maßstäbe.
Tests müssen unabhängig von derselben falschen Annahme entstehen
Wenn die KI Implementierung und Tests aus einem unklaren Prompt erzeugt, können beide denselben Fehler bestätigen. Kritische Beispiele werden daher aus Anforderungen, realen Vorfällen und unabhängigen Akzeptanzkriterien abgeleitet.
Der Assistent kann weitere Grenzfälle vorschlagen. Entwickler prüfen, ob sie fachlich relevant sind und tatsächlich scheitern würden. Browser-, Integrations- und Sicherheitstests ergänzen Unit-Tests.
Der geplante Beitrag Automatisiertes Testing mit KI vertieft Teststrategie und Wartung.
Sicherheitsprüfung bleibt außerhalb des Assistenten verankert
Promptregeln wie „schreibe sicheren Code“ sind keine Kontrolle. Abhängigkeitsprüfung, Secret Scanning, statische Analyse, Review und Tests laufen unabhängig vom gewählten Modell.
Die OWASP Top 10 bietet eine Orientierung für Webanwendungsrisiken. Kritische Authentifizierung, Berechtigungen und Zahlung werden besonders eng geprüft. Ein plausibler Vorschlag darf nicht direkt produktiv werden.
Öffentliche Codeübereinstimmungen und Lizenzen werden nach den Unternehmensregeln behandelt. Anbieterfunktionen können unterstützen, heben die eigene Prüfung aber nicht auf.
Teamregeln verhindern widersprüchliche private Arbeitsweisen
Zugelassene Werkzeuge, erlaubte Daten, Reviewpflichten und Umgang mit Agenten werden verständlich dokumentiert. Regeln unterscheiden kleine lokale Entwürfe von breiten Cloud-Aufträgen.
Repository-spezifische Anweisungen enthalten Stil, Architektur, Tests und verbotene Abhängigkeiten. Sie werden versioniert und im Review verbessert. Einzelne Entwickler müssen dieselben Grundlagen nicht in jedem Prompt neu erfinden.
Schulung zeigt bewusst fehlerhafte Ausgaben und gute Korrekturwege. Nur Erfolgsvorführungen erzeugen falsches Vertrauen.
Kosten umfassen Lizenzen, Nutzung und Prüfaufwand
Aktuelle Tarife werden aus offiziellen Quellen mit Abrufdatum verglichen. Neben Sitzplätzen können modell- oder nutzungsabhängige Kosten entstehen. Produktpakete ändern sich schnell und werden deshalb nicht als dauerhafte Zahl im Artikel festgeschrieben.
Entscheidend ist der vollständige wirtschaftliche Effekt. Verkürzt das Werkzeug eine geprüfte Aufgabe oder verschiebt es Arbeit in Review und Fehlerkorrektur? Zusätzliche Administration, Datenschutzprüfung und Schulung gehören zur Rechnung.
Ein begrenzter Pilot mit repräsentativen Aufgaben liefert belastbarere Daten als eine Hochrechnung aus Herstellerdemos.
Ein Pilot vergleicht mindestens zwei reale Arbeitsweisen
Ein Team bearbeitet ausgewählte Aufgaben mit bisherigem Prozess und mit Kandidaten. Ausgangscode, Qualitätskriterien und Zeitmessung bleiben vergleichbar. Entwickler dokumentieren Eingriffe und Unsicherheiten.
Die Stichprobe enthält Routine, unbekannten Code und eine sicherheitsrelevante Änderung. Ein Werkzeug, das nur bei Boilerplate glänzt, wird dadurch nicht zum allgemeinen Agentenstandard erklärt.
Am Ende kann die Entscheidung je Aufgabenklasse unterschiedlich ausfallen: Vervollständigung freigeben, Agenten enger pilotieren oder einen Kandidaten ablehnen.
Anbieterwechsel bleibt möglich, wenn Projektwissen im Repository liegt
Tests, Dokumentation, Regeln und Architekturentscheidungen werden nicht an ein proprietäres Chatformat gebunden. Kritische Automationen besitzen einen manuellen oder alternativen Weg.
Beim Wechsel werden Integrationen, Konten, gespeicherte Kontexte und Abrechnung kontrolliert beendet. Repository-Zugriffe und Tokens werden entzogen. Offene Agentänderungen werden abgeschlossen oder verworfen.
Werkzeugneutralität bedeutet nicht, jede Funktion austauschbar zu machen. Sie verhindert, dass die Wartbarkeit des Produkts mit einer einzelnen Anbieterfunktion endet.
Die Auswahlentscheidung braucht einen festen Prüftermin
Ein heute passendes Produkt kann durch neue Funktionen, Richtlinien oder Preise unpassend werden. Das Team definiert einen erneuten Prüfpunkt und beobachtet relevante Anbieteränderungen.
Kennzahlen zeigen Nutzung, Kosten, Reviewaufwand und Qualitätsvorfälle. Ein nicht genutzter Sitzplatz oder Agentenmodus wird nicht allein wegen eines Bündeltarifs beibehalten.
Neue Werkzeuge durchlaufen denselben Kriterienrahmen. So bleibt die Entscheidung offen für Fortschritt, ohne jedem Trend unkontrolliert Repository-Zugriff zu geben.
Promptqualität wird über reproduzierbare Aufgaben statt Schreibstil bewertet
Ein langer Prompt ist nicht automatisch besser. Relevante Dateien, erwartetes Verhalten, Grenzen und Testbefehl helfen mehr als allgemeine Adjektive. Das Team verwendet kleine Referenzaufgaben, um Anweisungen zu verbessern.
Ergebnisse werden nicht so lange nachgefragt, bis zufällig eine passende Antwort entsteht und nur dieser Versuch dokumentiert wird. Fehlversuche, Korrekturen und benötigte Hinweise gehören zur Aufwandserfassung.
Wiederkehrende Regeln wandern in versionierte Projektanweisungen. Aufgabenbezogener Kontext bleibt im Ticket oder Pull Request. Damit wird der Prozess für andere Entwickler nachvollziehbar.
MCP und externe Werkzeuge erweitern den Sicherheitsumfang
Ein agentischer Assistent kann über Werkzeugschnittstellen auf Tickets, Datenbanken, Browser oder Cloudsysteme zugreifen. Jede Verbindung besitzt eigene Berechtigungen, Datenwege und mögliche Aktionen.
Zugriff wird auf notwendige Systeme und möglichst lesende Operationen begrenzt. Kritische Änderungen benötigen Bestätigung oder bleiben vollständig außerhalb des Agenten. Fremde Toolausgaben gelten als untrusted Input und können den Agenten fehlleiten.
Server, Tokens und erlaubte Werkzeuge werden zentral inventarisiert. Ein privat hinzugefügter Connector darf nicht unbemerkt Kundencode oder interne Informationen an einen weiteren Dienst übertragen.
Geheimnisse werden nicht durch Promptverbote geschützt
Repository und Entwicklungsumgebung können API-Schlüssel, lokale Konfiguration oder Zugangsdaten enthalten. Ein Hinweis „zeige keine Secrets“ verhindert nicht zuverlässig, dass ein Werkzeug sie liest oder in Logs übernimmt.
Geheimnisse liegen in geeigneten Speichern, werden bei Tests durch begrenzte Werte ersetzt und erhalten kurze Rechte. Content Exclusion kann ergänzen, ist aber kein Ersatz für saubere Secret-Verwaltung.
Nach einem vermuteten Abfluss werden Schlüssel kontrolliert rotiert. Der Prozess muss auch funktionieren, wenn unklar ist, welcher Chat oder Agent welche Datei gesehen hat.
Branch, Diff und Pull Request bleiben die zentrale Kontrollfläche
Agentänderungen erfolgen in einem eigenen Branch. Der Pull Request beschreibt Auftrag, verwendete Werkzeuge, Tests und bekannte Grenzen. Große Diffs werden in verständliche Schritte geteilt.
Automatische Formatierung und generierte Dateien dürfen die fachliche Änderung nicht verdecken. Reviewer konzentrieren sich auf Verhalten, Daten und Sicherheitsgrenzen. Der Agent beantwortet nicht allein, ob seine eigene Änderung korrekt ist.
Geschützte Branches, erforderliche Checks und menschliche Freigaben bleiben unabhängig vom Werkzeug aktiv. Ein Assistent erhält keinen Sonderweg direkt in die Produktion.
Juniorentwickler benötigen mehr Erklärung und nicht nur mehr Vorschläge
Ein KI-Assistent kann Lernende schnell zu funktionierend wirkendem Code führen. Ohne Grundlagen fällt es schwer, falsche Annahmen, Sicherheitsprobleme oder unnötige Komplexität zu erkennen.
Teams nutzen Vorschläge als Gesprächsgrundlage. Entwickler erklären Architektur und Test, bevor sie eine Änderung übernehmen. Mentoring bewertet Verständnis statt bloßer Ausgabegeschwindigkeit.
Aufgaben mit klarer Grenze und guter Testbarkeit eignen sich zuerst. Kritische Authentifizierung oder Datenmigration bleibt unter enger Begleitung. Das Werkzeug soll Kompetenz erweitern und keine dauerhafte Wissenslücke verdecken.
Auditlogs helfen nur mit definiertem Prüfzweck
Unternehmenspläne können Richtlinien- und Nutzungsinformationen anbieten. Welche Ereignisse verfügbar sind, hängt vom Produkt und Plan ab und wird aktuell geprüft. Protokolle dürfen nicht pauschal zur Leistungsüberwachung einzelner Entwickler missbraucht werden.
Sinnvolle Zwecke sind ungewöhnliche Zugriffe, nicht freigegebene Funktionen, Kostenentwicklung und Incident-Aufklärung. Zugriff auf Logs bleibt begrenzt, Aufbewahrung festgelegt und Auswertung transparent.
Eine hohe Zahl Agentensitzungen zeigt weder Produktivität noch Qualität. Metriken werden mit Review, Fehlern und vollständiger Durchlaufzeit verbunden.
Beschaffung braucht einen technischen Exit-Test vor Vertragsbindung
Neben Datenschutz- und Vertragsprüfung wird praktisch getestet, wie Konten, gespeicherte Kontexte, Regeln und Integrationen beendet werden. Repository-Zugriffe müssen vollständig entziehbar und Daten nach den vereinbarten Regeln löschbar sein.
Ein Anbieterwechsel darf Build, Test oder Deployment nicht blockieren. Kritische Workflows bleiben in unternehmenskontrollierten Systemen. Proprietäre Automationen werden nur dort eingesetzt, wo ihr Nutzen die Bindung rechtfertigt.
Die Entscheidung dokumentiert akzeptierte Abhängigkeiten. So bleibt ein späterer Wechsel ein planbares Projekt und wird nicht erst nach einer Preis- oder Produktänderung untersucht.
Der Assistent muss zur Architektur individueller Webanwendungen passen
In einer individuellen Webanwendung greifen Oberfläche, Datenmodell, Rollen und externe Systeme zusammen. Ein Code-Assistent darf eine lokale Funktion nicht optimieren, indem er diese Grenzen umgeht oder eine zweite Datenquelle einführt.
Bei Integrationen helfen aktuelle Verträge und der Leitfaden zu belastbaren Schnittstellen als Kontext. Generierte Clients erhalten Validierung, Wiederholung und Monitoring. Der schnellste Happy Path ist kein produktionsreifer Datenfluss.
SW Business Solutions verbindet Werkzeugauswahl mit individueller Softwareentwicklung. Das Team bewertet daher nicht nur Vorschlagsqualität, sondern ob der Assistent wartbaren Code innerhalb der vereinbarten Architektur unterstützt.
SW Business Solutions führt KI-Code-Assistenten über einen kontrollierten Pilot ein
SW Business Solutions bewertet Werkzeuge anhand vorhandener Codebasis, Datenklassifikation, Teamprozess und Qualitätsanforderungen. Der Pilot verbindet repräsentative Aufgaben mit Review, Tests und vollständiger Aufwandserfassung.
In einer Analyse für KI-gestützte Entwicklungsprozesse werden Kandidaten, Rechte, Regeln und Messwerte festgelegt. Die Empfehlung kann je Aufgabenklasse unterschiedlich ausfallen.
Das gewünschte Ergebnis ist kein möglichst autonomer Agent. Es ist ein Entwicklungsprozess, der schneller zu geprüftem Code gelangt und dabei Sicherheit, Wissen und Betriebsfähigkeit unter Kontrolle behält.