KI-automatisiertes Testing für Webanwendungen: Tests schneller entwickeln, Ergebnisse kontrolliert bewerten
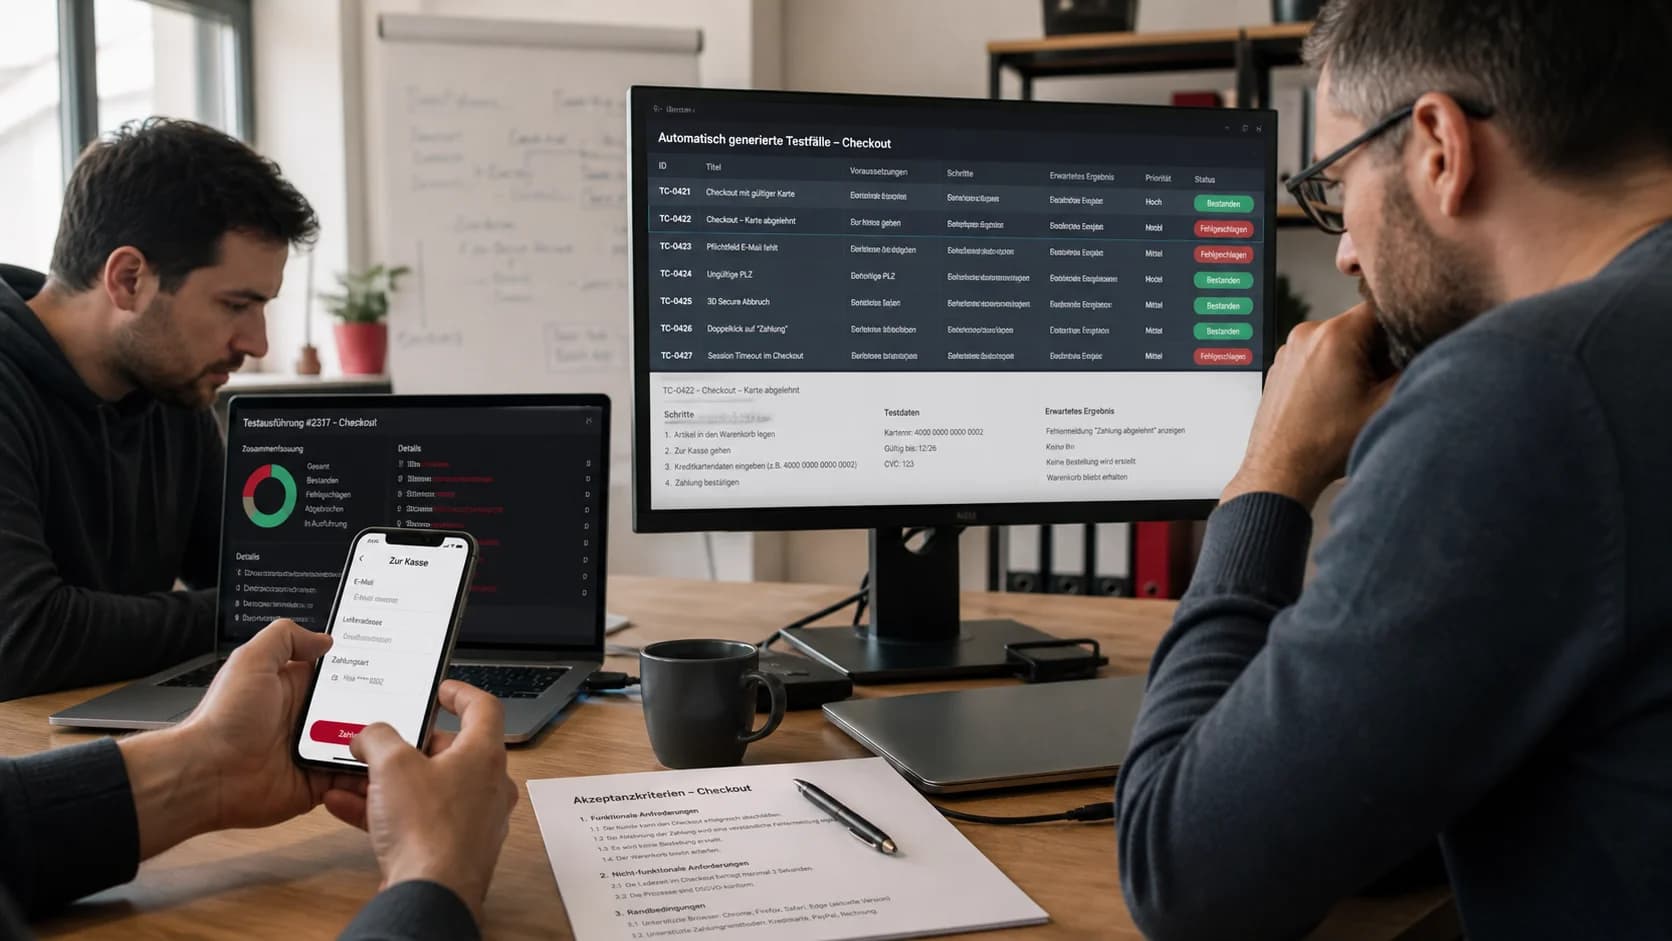

KI automatisiertes Testing für Webanwendungen: Testfälle ableiten, Testcode erstellen, Fehler bewerten und Qualität kontrolliert integrieren.
KI-automatisiertes Testing für Webanwendungen: Tests schneller entwickeln, Ergebnisse kontrolliert bewerten
Ein generierter Test kann grün anzeigen, obwohl er nur prüft, ob irgendein Button sichtbar ist. Ein sorgfältig formulierter Test erkennt dagegen, dass eine Buchung den richtigen Preis, Kunden und Status erhalten muss. KI automatisiertes Testing für Webanwendungen beschleunigt Teile der Testarbeit, übernimmt aber nicht die fachliche Definition von Qualität.
Der Nutzen entsteht, wenn KI bekannte Anforderungen in Testentwürfe übersetzt, Varianten ergänzt und Fehler bei der Analyse vorsortiert. Freigabe, Testdaten und geschäftliche Erwartungen bleiben unter menschlicher Kontrolle.
KI automatisiertes Testing für Webanwendungen beginnt mit einem prüfbaren Geschäftsablauf
„Das Formular funktioniert“ ist keine ausreichende Erwartung. Ein prüfbarer Ablauf beschreibt Ausgangsdaten, Eingabe, Ergebnis und sichtbare Nebenwirkungen. Bei einer Buchung gehören Verfügbarkeit, Preis, Bestätigung und Eintrag im Verwaltungssystem zusammen.
KI kann aus einer solchen Beschreibung Testschritte vorschlagen. Fehlen jedoch Regeln für Stornierung, Doppelbuchung oder Zahlungsausfall, erfindet das Modell entweder Annahmen oder ignoriert die Lücke.
Deshalb startet die Testautomatisierung mit einem fachlichen Beispiel. Das Team entscheidet, welche Abweichung geschäftlich kritisch ist und welche lediglich die Darstellung betrifft.
Testpyramide und Risikoprofil bestimmen den sinnvollen Automationsgrad
Kleine Unit-Tests prüfen einzelne Funktionen schnell und gezielt. Integrationstests kontrollieren das Zusammenspiel von Datenbank, API oder Dienst. End-to-End-Tests durchlaufen die Anwendung wie ein Nutzer, sind aber langsamer und störanfälliger.
KI ändert diese Eigenschaften nicht. Sie kann Testcode auf mehreren Ebenen erzeugen, doch ein vollständig über Browser bedienter Testbestand bleibt teuer in Ausführung und Wartung.
Das Risikoprofil ordnet Tests den Folgen zu. Preisberechnung, Berechtigung und Zahlung brauchen tiefere Kontrollen als eine austauschbare Animation. Anzahl und Ebene folgen dem Fehlerbild, nicht einem Zielwert für Testabdeckung.
Anforderungen werden in konkrete Beispiele und Gegenbeispiele übersetzt
Eine Regel wie „Rabatt gilt für Firmenkunden“ lässt mehrere Fragen offen: Welche Kundengruppe zählt, wann wird der Status geprüft und lässt sich der Rabatt kombinieren? Testfälle machen diese Unklarheit sichtbar.
Ein Sprachmodell kann Grenzfälle vorschlagen: fehlender Status, abgelaufene Berechtigung, Rundung oder parallele Änderung. Der Product Owner bestätigt, welche Varianten tatsächlich gelten.
So dient KI als strukturierter Sparringspartner. Sie ersetzt keine Fachentscheidung, hilft aber dabei, unausgesprochene Annahmen vor der Implementierung zu entdecken.
KI erzeugt Testentwürfe schneller, wenn Kontext und Konventionen vorliegen
Guter Testcode folgt der bestehenden Projektstruktur, verwendet gemeinsame Hilfsfunktionen und benennt Ergebnisse verständlich. Ohne diesen Kontext erzeugt KI isolierte Beispiele, die zwar plausibel aussehen, aber nicht in die Testsuite passen.
Der Prompt enthält Framework, relevante Schnittstelle, Datenmodell und vorhandene Konventionen. Noch besser ist ein kontrollierter Zugriff auf ausgewählte Projektdateien. Geheimnisse und produktive Kundendaten gehören nicht in den Kontext.
Jeder Entwurf wird ausgeführt und fachlich gelesen. Syntaktisch korrekter Code kann die falsche Eigenschaft prüfen oder einen Fehler durch zu großzügige Bedingungen verdecken.
Unit-Tests profitieren von Varianten, nicht von blind erzeugter Masse
Für reine Funktionen kann KI Eingabeklassen, Grenzwerte und erwartete Ausgaben ableiten. Besonders nützlich sind Tabellen mit mehreren fachlich unterschiedlichen Fällen.
Viele nahezu identische Tests erhöhen den Wartungsaufwand, ohne neues Risiko abzudecken. Das Team entfernt Duplikate und benennt, welchen Fehler jeder Test verhindern soll.
Mocks werden sparsam verwendet. Wenn ein Test sämtliche echte Logik durch Modellobjekte ersetzt, bestätigt er nur seine eigene Vorbereitung. Kritische Integrationen brauchen ergänzende Tests gegen einen realistischen Vertrag.
API-Tests prüfen Datenverträge, Berechtigungen und Fehlerfälle
Eine erfolgreiche Antwort mit Status 200 beweist noch keinen korrekten Geschäftsprozess. API-Tests kontrollieren Pflichtfelder, Datentypen, fachliche Werte und gespeicherte Nebenwirkungen.
Negative Fälle versuchen ungültige Eingaben, fehlende Authentifizierung und Zugriff auf fremde Datensätze. KI kann diese Matrix aus einer Schnittstellenbeschreibung vorbereiten. Sie darf Berechtigungsregeln nicht selbst erraten.
Bei externen APIs werden Timeouts, Rate Limits und veränderte Antworten simuliert. Die Entwicklung belastbarer Schnittstellen beschreibt zusätzlich Wiederholung, Protokollierung und Fehlerwarteschlangen.
Browsertests sollten stabile Nutzerabsichten statt zufälliger DOM-Strukturen verwenden
Automatisierte Browser bedienen Formulare, Navigation und Dialoge. Selektoren nach sichtbarer Rolle, Beschriftung oder gezielter Test-ID sind stabiler als verschachtelte CSS-Pfade.
Playwright empfiehlt sogenannte web-first Assertions, die auf den erwarteten Zustand warten und Prüfungen wiederholen. Das reduziert starre Wartezeiten, die auf schnellen Systemen Zeit verschwenden und auf langsamen Systemen trotzdem scheitern.
KI kann Locator und Schritte erzeugen. Das Team prüft, ob der Test tatsächlich die Nutzerabsicht abbildet oder nur die aktuelle HTML-Struktur kopiert.
Visuelle Tests erkennen Veränderungen, aber nicht automatisch deren Bedeutung
Screenshot-Vergleiche finden verschobene Elemente, andere Farben oder fehlende Inhalte. Dynamische Daten, Schriften und unterschiedliche Renderumgebungen können jedoch harmlose Abweichungen erzeugen.
Stabile Testdaten und definierte Browsergrößen reduzieren Rauschen. Kritische Komponenten werden gezielt erfasst, statt jede lange Seite als unübersichtliches Bild zu vergleichen.
KI kann Unterschiede beschreiben und gruppieren. Ob eine Änderung beabsichtigt, barrierefrei und markenkonform ist, entscheidet weiterhin ein Verantwortlicher. Ein automatisch aktualisiertes Referenzbild darf keinen Fehler einfach bestätigen.
Testdaten bleiben künstlich, reproduzierbar und fachlich aussagekräftig
Produktive Personen- oder Zahlungsdaten werden nicht in Testumgebungen kopiert, nur weil sie realistisch wirken. Testdatensätze bilden notwendige Eigenschaften synthetisch ab.
Jeder Test erzeugt seinen Ausgangszustand oder verwendet eine versionierte, bekannte Grundlage. Abhängigkeiten von der Reihenfolge machen Ergebnisse unzuverlässig. Nach dem Lauf werden angelegte Daten kontrolliert entfernt oder die Umgebung zurückgesetzt.
Website-Qualitäts-Check
Wie gut ist Ihre Website wirklich? Technik, SEO & Conversion im Check.
- Qualitäts-Score 0–100
- Stärken und Schwachstellen
- Konkrete Verbesserungen
- Bericht per E-Mail
KI kann Datensätze variieren, darf aber keine echten Namen, Adressen oder vertraulichen Inhalte aus Projektkontext reproduzieren. Datenschutz und Reproduzierbarkeit verfolgen hier dasselbe Ziel.
Prompt- und Modelltests benötigen andere Qualitätsmaßstäbe als deterministische Funktionen
Wenn die Webanwendung selbst ein Sprachmodell nutzt, kann dieselbe Anfrage unterschiedlich beantwortet werden. Ein Test auf den exakt gleichen Satz ist dann oft ungeeignet.
Bewertet werden strukturierte Eigenschaften: erlaubte Felder, Quellenbezug, verbotene Inhalte, korrekte Übergabe und menschliche Freigabe. Eine kleine Sammlung repräsentativer Fälle bildet den tatsächlichen Einsatz ab.
Automatische Modellbewertungen können vorsortieren, dürfen aber nicht unbemerkt zum einzigen Qualitätsurteil werden. Stichproben und fachliche Grenzfälle bleiben erforderlich.
Regressionstests schützen die Abläufe, die bereits zuverlässig funktionieren
Nach einer Fehlerkorrektur wird ein Test ergänzt, der genau den früheren Fehler reproduziert. Damit verhindert die Testsuite, dass eine spätere Änderung denselben Defekt zurückbringt.
KI kann aus Fehlerbeschreibung, Log und Codeänderung einen Entwurf erstellen. Dieser Test wird zuerst gegen den fehlerhaften Stand ausgeführt. Scheitert er dort nicht, beweist er die Korrektur nicht.
Die Regression wird auf der niedrigsten sinnvollen Testebene verankert. Ein schneller Integrationstest ist oft langlebiger als ein kompletter Browserlauf für eine kleine Berechnungsregel.
Code-Reviews mit KI ergänzen, aber ersetzen keine verantwortliche Freigabe
KI-gestützte Reviews können auf fehlende Tests, mögliche Fehler oder schwer verständliche Änderungen hinweisen. GitHub weist in seiner Dokumentation ausdrücklich darauf hin, dass automatisch erzeugtes Feedback validiert werden muss und menschliche Reviews ergänzt.
Der Reviewer prüft Architektur, Geschäftsregel und Sicherheitsfolgen. Ein Modell kennt nicht automatisch die internen Annahmen oder akzeptierten Risiken des Unternehmens.
Hinweise werden wie andere Befunde behandelt: nachvollziehen, priorisieren und testen. Eine große Anzahl automatisch formulierter Kommentare darf kritische Punkte nicht unter Lärm begraben.
Fehlgeschlagene Tests werden nach Ursache statt nur nach Symptom sortiert
Ein Fehler kann aus Produktdefekt, instabiler Testumgebung, veraltetem Test oder externer Störung entstehen. KI kann Logs, Screenshots und letzte Änderungen zusammenfassen und ähnliche Fehler gruppieren.
Die Zuordnung bleibt überprüfbar. Eine plausible Erklärung ohne Beleg darf einen roten Test nicht automatisch schließen. Reproduktionsschritt und verantwortliche Komponente werden dokumentiert.
Wiederkehrende Infrastrukturfehler erhalten eine eigene Maßnahme. Tests ständig neu zu starten, bis der Lauf grün ist, verschleiert die reale Zuverlässigkeit des Releaseprozesses.
Flaky Tests werden repariert oder entfernt, nicht statistisch schöngerechnet
Ein Test, der gelegentlich ohne Produktänderung scheitert, verliert Vertrauen. Häufige Ursachen sind starre Wartezeiten, gemeinsam genutzte Daten, ungeklärte Nebenläufigkeit oder externe Abhängigkeiten.
KI kann Muster in Fehlermeldungen erkennen und verdächtige Stellen vorschlagen. Die Korrektur wird durch wiederholte kontrollierte Läufe geprüft.
Quarantäne ist eine kurzfristige Maßnahme mit Eigentümer und Termin. Ein dauerhaft ignorierter Test schützt nichts und verlängert jeden Release. Ist der geprüfte Wert unwichtig, wird der Test bewusst gelöscht.
Die CI-Pipeline ordnet Tests nach Geschwindigkeit und Risiko
Schnelle Prüfungen laufen bei jeder Änderung. Umfangreichere Browser-, Last- oder Sicherheitstests können nachgelagert oder vor einer Freigabe ausgeführt werden.
Die Reihenfolge liefert frühes Feedback, ohne Entwickler lange auf triviale Fehler warten zu lassen. Kritische Regeln bleiben trotzdem verbindliche Freigabebedingung.
KI kann anhand geänderter Dateien relevante Tests vorschlagen. Eine risikobasierte Auswahl benötigt jedoch einen sicheren Rückfall: Änderungen an gemeinsamem Datenmodell oder Authentifizierung dürfen nicht wegen einer zu engen Prognose ungetestet bleiben.
Testabdeckung ist ein Signal und kein Qualitätsziel für sich
Code Coverage zeigt, welche Zeilen oder Zweige während Tests ausgeführt wurden. Sie zeigt nicht, ob sinnvolle Erwartungen formuliert sind. Ein Test ohne präzise Assertion kann viel Code abdecken und wenig schützen.
Ungeprüfte kritische Bereiche werden sichtbar gemacht. Gleichzeitig muss nicht jeder triviale Getter einen eigenen Test erhalten.
KI kann Lücken markieren und Testideen erzeugen. Das Team priorisiert anhand von Geschäftsrisiko, Änderungshäufigkeit und Fehlerkosten. Eine hohe Prozentzahl ohne belastbare Kernprozesse ist kein Freigabeargument.
Sicherheitstests brauchen explizite Regeln und getrennte Werkzeuge
Generierte Tests können ungültige Eingaben, Rollenwechsel und Zugriff auf fremde Ressourcen prüfen. Automatische Abhängigkeits- und Konfigurationsscanner ergänzen bekannte Risikomuster.
Ein Sprachmodell ersetzt keinen autorisierten Penetrationstest. Umfang, Umgebung und erlaubte Methoden werden vor Sicherheitsprüfungen festgelegt, damit Verfügbarkeit und Daten geschützt bleiben.
Die technischen Sicherheitsmaßnahmen für Unternehmenswebsites verbinden Tests mit Konten, Monitoring und Vorfallreaktion.
Barrierefreiheit wird in Automation und manuelle Nutzung aufgeteilt
Werkzeuge erkennen beispielsweise fehlende Namen, bestimmte Kontrastprobleme oder ungültige Strukturen. Sie können nicht vollständig beurteilen, ob Reihenfolge, Sprache und Bedienung für Menschen verständlich sind.
Automatische Prüfungen laufen regelmäßig und verhindern bekannte Regressionen. Tastaturtest, Vergrößerung und Nutzung mit assistiven Technologien ergänzen die technische Kontrolle.
KI kann Befunde erklären und Korrekturvorschläge liefern. Die Umsetzung wird am betroffenen Element überprüft, weil eine formal plausible ARIA-Ergänzung die Bedienung auch verschlechtern kann.
Performance-Tests trennen Laborwerte von realem Nutzerverhalten
Laborläufe vergleichen Versionen unter kontrollierten Bedingungen. Felddaten zeigen, wie echte Geräte, Netze und Inhalte reagieren. Beide Perspektiven beantworten unterschiedliche Fragen.
KI kann auffällige Ressourcen, lange Aufgaben oder zeitliche Zusammenhänge zusammenfassen. Der belegte Engpass wird anschließend im Code, Hosting oder Drittanbieter gesucht.
Die Core Web Vitals für Unternehmenswebsites dürfen nicht durch einmalige Idealwerte abgehakt werden. Relevante Seitentypen und Nutzerwege werden nach Releases weiter beobachtet.
Datenschutz beginnt bereits beim eingesetzten KI-Testwerkzeug
Vor dem Einsatz wird geklärt, welche Quelltexte, Logs, Screenshots und Prompts an einen Anbieter übertragen werden. Zugangsdaten, personenbezogene Testinhalte und interne URLs werden nicht unkontrolliert geteilt.
Vertrag, Speicherort, Aufbewahrung und Modellnutzung werden passend zur Unternehmensvorgabe geprüft. Technische Filter reduzieren sensible Inhalte, ersetzen aber keine bewusste Auswahl des Kontexts.
Lokale oder abgeschottete Modelle können bei besonderen Anforderungen sinnvoll sein. Sie verursachen eigenen Betriebsaufwand und sind nicht allein durch ihren Speicherort automatisch geeignet.
Ein Shadow-Modus prüft KI-Vorschläge ohne automatische Freigabe
Zu Beginn erzeugt die KI Testfälle, Klassifizierungen oder Reviewhinweise, ohne Releases zu blockieren oder Befunde selbst zu schließen. Das Team vergleicht Vorschläge mit seiner bisherigen Arbeit.
Gemessen werden brauchbare Hinweise, übersehene kritische Fälle, falsche Alarme und eingesparte Bearbeitungszeit. Dadurch zeigt sich, für welche Aufgaben der Ansatz im konkreten Projekt geeignet ist.
Erst nach stabiler Bewertung werden ausgewählte Schritte verbindlich. Vollautomatische Freigaben bleiben auf klar begrenzte, deterministische Prüfungen beschränkt.
Testwartung wird als Teil der Produktentwicklung geplant
Neue Funktionen verändern Selektoren, Daten und Erwartungen. Tests benötigen deshalb denselben Qualitätsanspruch wie Produktionscode: verständliche Namen, gemeinsame Hilfen und Reviews.
KI beschleunigt Anpassungen, kann aber veraltete Annahmen fortschreiben. Bei einer geänderten Geschäftsregel werden Erwartung und Dokumentation zuerst bestätigt.
Das Team beobachtet Laufzeit, Instabilität und Wartungsaufwand. Langsame oder redundante Tests werden verbessert. Automatisierung soll Releases verlässlicher machen, nicht eine zweite unübersichtliche Anwendung erzeugen.
Kennzahlen bewerten Fehlerwirkung statt erzeugte Testmenge
Die Zahl generierter Tests sagt wenig über Nutzen. Aussagekräftiger sind entdeckte Regressionen vor dem Release, Zeit bis zur Ursachenanalyse und Anteil instabiler Tests.
Bei kritischen Nutzerwegen wird verfolgt, welche Fehlerklassen abgedeckt sind. Eine Zahlung kann fachlich, technisch und in der Übergabe scheitern; ein einzelner Happy-Path-Test deckt das nicht ab.
Kennzahlen werden nicht als Garantie formuliert. Sie helfen, Engpässe zu erkennen und den Testbestand gezielt zu verbessern.
Ein Pilot startet mit einem häufig geänderten und geschäftlich relevanten Ablauf
Geeignet ist ein Prozess, dessen Regeln bekannt sind und der regelmäßig geprüft werden muss: Anfragequalifizierung, Buchung oder Angebotserstellung. Ein chaotischer Sonderfall ohne fachlichen Eigentümer ist kein guter Einstieg.
Der Pilot umfasst vorhandene Tests, KI-unterstützte Ergänzung, Ausführung in der Pipeline und gemeinsame Auswertung. Produktivdaten bleiben ausgeschlossen.
Nach wenigen Iterationen steht eine konkrete Entscheidung: Ansatz erweitern, auf bestimmte Aufgaben begrenzen oder stoppen. Ein beeindruckender Demo-Test ohne Integration in den Releaseprozess reicht nicht.
Die Make-or-Buy-Entscheidung betrifft Werkzeug und Prozess getrennt
Standardwerkzeuge für Testausführung, Browserautomation und Codeanalyse müssen selten neu entwickelt werden. Individuell sind dagegen Geschäftsregeln, Testdaten, Integrationen und Freigabekriterien.
Ein KI-Dienst kann Entwürfe und Analyse liefern. Bei sensiblen Codebeständen oder besonderen Workflows kann eine eigene Integration sinnvoll sein. Sie benötigt Modellbetrieb, Rechte, Protokollierung und Evaluation.
SW Business Solutions verbindet vorhandene Werkzeuge mit dem kundenspezifischen Entwicklungsprozess. Es geht nicht darum, eine fertige KI-Schaltfläche zu verkaufen, sondern den Testfluss messbar zu verbessern.
Freigabeverantwortung bleibt auch bei hoher Automatisierung eindeutig
Ein grüner Lauf bestätigt nur die implementierten Erwartungen. Ungetestete Geschäftsregeln, unvollständige Daten und neue Risiken bleiben außerhalb dieses Signals.
Für jeden Release ist festgelegt, wer Ergebnisse bewertet, Ausnahmen genehmigt und offene Befunde dokumentiert. KI darf Hinweise priorisieren, aber keine geschäftliche Risikoakzeptanz vortäuschen.
Die professionelle Nutzung von KI in der Webentwicklung ordnet diese Verantwortung in Planung, Code und Betrieb ein. Automatisierung stärkt die Entscheidung, sie ersetzt sie nicht.
SW Business Solutions integriert KI-gestützte Tests in reale Entwicklungs- und Freigabeprozesse
SW Business Solutions analysiert kritische Nutzerwege, vorhandene Tests und Releaseprobleme. Daraus entwickeln wir eine passende Kombination aus Unit-, API-, Browser-, Sicherheits- und Qualitätsprüfungen.
KI wird dort eingesetzt, wo sie Testentwürfe, Varianten oder Fehleranalyse nachweisbar beschleunigt. Fachliche Erwartungen, Datenschutz und Freigaben bleiben klar geregelt. Auf Wunsch integrieren wir bestehende Werkzeuge oder bauen eine kundenspezifische Test- und Auswertungslösung.
Ein Pilot für KI-gestützte Testautomatisierung startet mit einem konkreten Geschäftsablauf. Das Dream Outcome ist ein Releaseprozess, der Fehler früher sichtbar macht und weniger manuelle Wiederholungsarbeit erzeugt, ohne falsche Sicherheit zu verkaufen.