

Datensilos technisch auflösen: So entsteht ein zentraler Informationsfluss
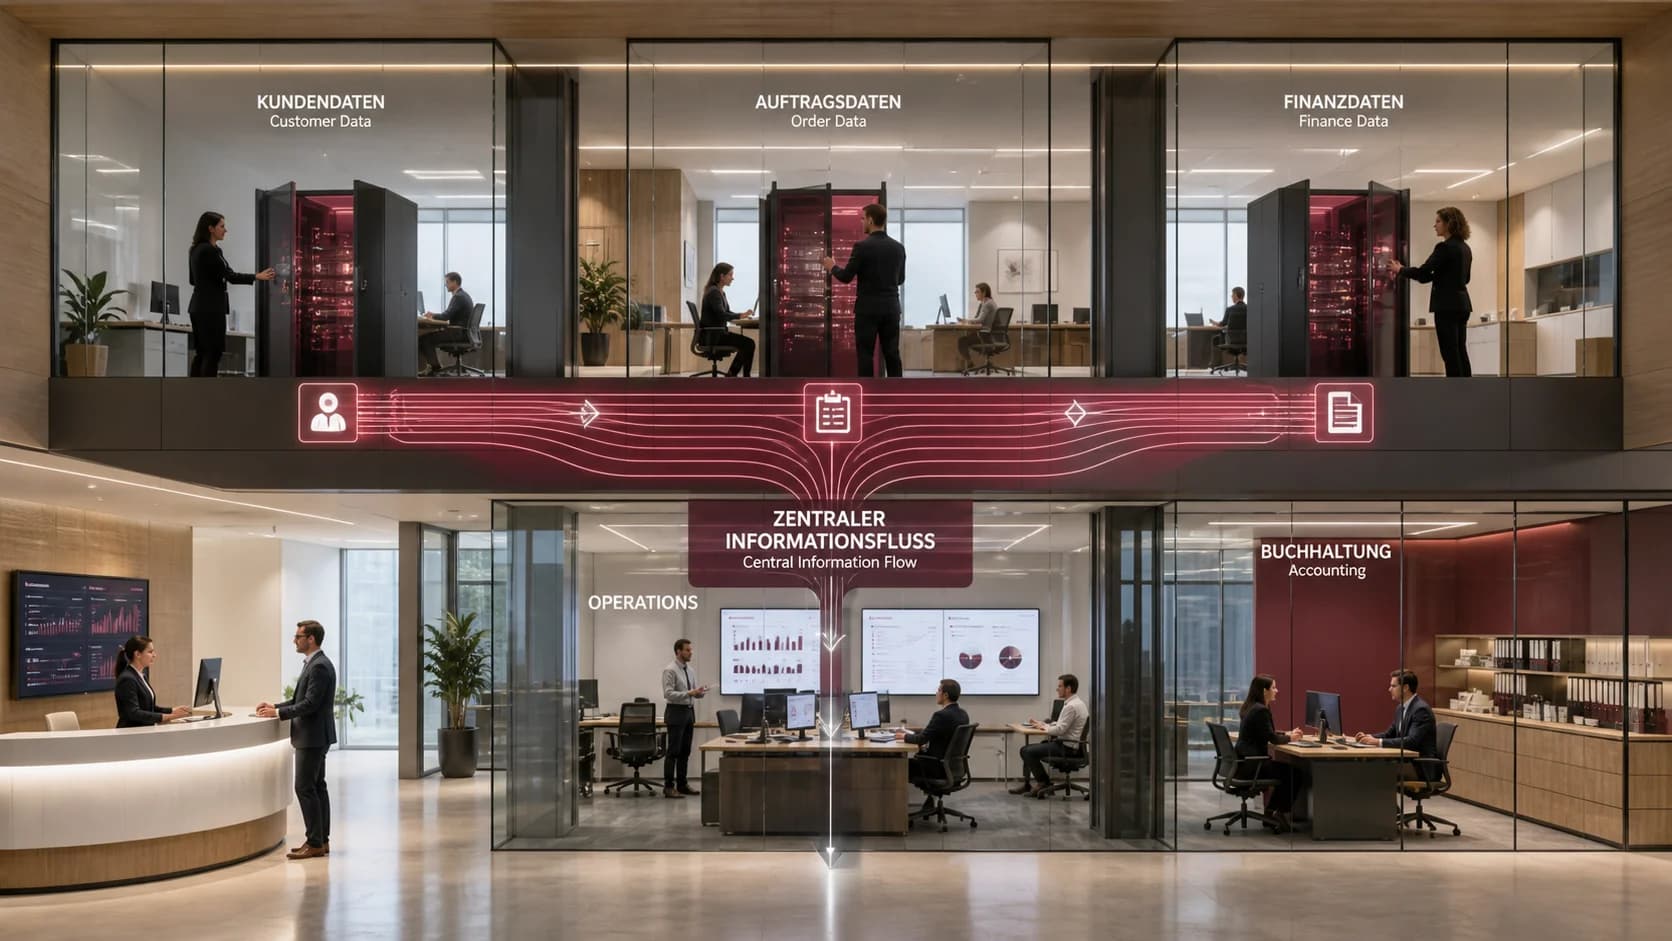

Datensilos technisch auflösen: Datenquellen, führende Systeme, APIs, Stammdaten und Auswertungen zu einem verlässlichen Informationsfluss verbinden.
Datensilos technisch auflösen: So entsteht ein zentraler Informationsfluss
Der Vertrieb sieht im CRM einen aktiven Kunden. Im ERP ist derselbe Kunde gesperrt, im Supportsystem läuft ein kritisches Ticket und die Geschäftsführung wertet eine exportierte Tabelle vom Vormonat aus. Alle Daten sind vorhanden. Weil sie isoliert bleiben, entsteht trotzdem kein verlässliches Gesamtbild. Wer Datensilos technisch auflösen will, braucht deshalb mehr als eine zentrale Datenbank.
Ein Datensilo entsteht, wenn Informationen nur in einer Anwendung, Abteilung oder Datei verfügbar sind und andere Prozesse sie nicht verlässlich verwenden können. Die Lösung besteht aus fachlicher Verantwortung, eindeutigen IDs, abgestimmten Datenmodellen und passenden Integrationswegen.
SW Business Solutions verbindet operative Systeme, Datenquellen und individuelle Anwendungen. Ziel ist ein kontrollierter Informationsfluss: Daten entstehen an einer verantwortlichen Stelle, werden für konkrete Zwecke bereitgestellt und bleiben hinsichtlich Herkunft, Aktualität und Qualität nachvollziehbar.
Datensilos sind nicht grundsätzlich ein Fehler
Ein Personalsystem soll nicht automatisch alle Daten mit CRM und Projektplattform teilen. Eine Buchhaltung benötigt eigene Kontrollen und Aufbewahrungsregeln. Fachsysteme kapseln komplexe Aufgaben bewusst.
Problematisch wird die Trennung, wenn derselbe Sachverhalt mehrfach gepflegt wird oder relevante Informationen den nächsten Prozessschritt nicht erreichen. Dann entstehen widersprüchliche Kundenadressen, manuelle Exporte, verspätete Entscheidungen und schwer erklärbare Kennzahlen.
Das Ziel lautet nicht, jede Information überall verfügbar zu machen. Es lautet, erforderliche Daten mit klarer Bedeutung, Berechtigung und Aktualität an den richtigen Prozess zu liefern.
Der Leitfaden zu Schnittstellen und Systemintegration ordnet APIs, Webhooks, Dateiwege und Middleware in die gesamte Unternehmensarchitektur ein.
Der Geschäftsprozess zeigt relevante Silogrenzen
Eine Inventarliste aller Anwendungen kann umfangreich sein, ohne den wichtigsten Engpass zu zeigen. Deshalb beginnt die Analyse mit einem Vorgang: Anfrage, Angebot, Auftrag, Leistung, Rechnung oder Störung.
Für jeden Schritt wird notiert, welche Information benötigt wird, wo sie entsteht und wie sie weitergegeben wird. Manuelle Kopien, E-Mail-Anhänge, Tabellen und telefonische Rückfragen markieren mögliche Silogrenzen.
Nicht jede Grenze hat dieselbe Wirkung. Ein monatlicher Export für eine seltene Auswertung kann ausreichend sein. Eine fehlende Verfügbarkeitsinformation im Verkaufsprozess kann dagegen unmittelbar falsche Zusagen erzeugen.
Priorität erhalten Übergaben mit hohem Aufwand, hoher Fehlerwirkung oder direktem Einfluss auf Kunden, Umsatz und Betrieb.
Ein Systeminventar erfasst mehr als Produktnamen
Für jede Anwendung werden Zweck, Verantwortlicher, Nutzer, Datenobjekte, Schnittstellen, Exportmöglichkeiten, Vertrag, Betrieb und Schutzbedarf dokumentiert. Tabellen, lokale Datenbanken und automatisierte Dateien gehören ebenfalls dazu.
Entscheidend ist, welche Daten das System verbindlich führt. Ein CRM kann Kunde, Kontakt und Vertriebsstatus enthalten; ein ERP führt Auftrag, Artikel und Lieferung; ein Supportsystem Ticket und Lösungshistorie.
Schattenlösungen werden sachlich erfasst. Eine Fachabteilung nutzt eine Tabelle meist, weil ein realer Bedarf nicht erfüllt ist. Die Analyse prüft, ob dieser Bedarf in ein führendes System, eine Integration oder eine eigene Anwendung gehört.
Nicht genutzte und doppelte Systeme werden sichtbar. Eine technische Verbindung zu einer Anwendung, die ohnehin abgelöst wird, wäre möglicherweise Fehlinvestition.
Datenobjekte benötigen fachliche Eigentümer
Kunde, Ansprechpartner, Produkt, Standort, Vertrag, Auftrag und Dokument sind fachliche Objekte. Für jedes Objekt wird ein verantwortlicher Bereich und ein führendes System benannt.
Der Eigentümer entscheidet Definition, Pflichtangaben, erlaubte Werte und Korrekturprozess. Die IT betreibt Systeme und Schnittstellen, kann aber nicht allein festlegen, wann zwei Unternehmen fachlich derselbe Kunde sind.
Verantwortung kann nach Prozessphase wechseln. Ein Interessent entsteht im CRM. Nach Vertragsabschluss wird ein Debitor im ERP angelegt. Beide Datensätze bleiben über IDs verbunden, besitzen aber unterschiedliche Zwecke.
Ohne Eigentümerschaft wird ein zentraler Datenbestand schnell zum neuen Silo: technisch gesammelt, fachlich ungeklärt und von niemandem verlässlich gepflegt.
Ein gemeinsames Begriffsmodell verhindert Scheinkonsistenz
„Kunde“ kann im Vertrieb eine Organisation mit Verkaufschance bedeuten, in der Buchhaltung einen Debitor und im Support jeden Nutzer mit Zugang. Eine zentrale Tabelle mit einer Kundenspalte löst diese Bedeutungsunterschiede nicht.
Ein fachliches Datenmodell beschreibt Objekte, Beziehungen und Lebenszyklen. Es legt beispielsweise fest, wie Unternehmen, Standort, Rechnungsempfänger und Ansprechpartner zusammenhängen.
Statuswerte werden nach ihrer Wirkung definiert. „Aktiv“ kann Vertrag, Nutzung oder Vertriebsbeziehung meinen. Unterschiedliche Bedeutungen erhalten unterschiedliche Felder statt einer scheinbar gemeinsamen Kennzeichnung.
Das Modell muss nicht jede Anwendung identisch machen. Es schafft eine Übersetzung, auf die Integrationen, Auswertungen und Mitarbeiter sich beziehen können.
Eindeutige IDs verbinden Datensätze über Systeme hinweg
Namen und E-Mail-Adressen verändern sich und sind nicht immer eindeutig. Stabile technische IDs verbinden denselben fachlichen Datensatz zwischen CRM, ERP, DMS und weiteren Anwendungen.
Jedes System behält seine interne ID. Eine Zuordnungstabelle oder externe Referenz speichert die Beziehungen. Dadurch kann eine Integration gezielt aktualisieren, statt anhand unsicherer Texte neu zu suchen.
Beim ersten Abgleich werden Dubletten nicht blind zusammengeführt. Eindeutige Regeln automatisieren sichere Fälle; unsichere Treffer erhalten eine fachliche Prüfung.
IDs gelten auch für Vorgänge und Dokumente. Auftrag, Ticket, Rechnung und Datei bleiben über Referenzen verbunden, ohne alle Inhalte in ein einziges System zu kopieren.
Stammdatenmanagement stabilisiert wiederverwendete Informationen
Stammdaten wie Kunden, Artikel, Standorte und Mitarbeiterrollen werden in vielen Prozessen verwendet. Fehler verbreiten sich entsprechend weit. Master Data Management beschreibt Regeln, Rollen und technische Wege für ihre konsistente Pflege.
Für den Mittelstand muss daraus keine große Plattform entstehen. Ein klar führendes ERP für Artikel, ein CRM für Interessenten und ein dokumentierter Übergabeprozess können ausreichen.
Validierungen verhindern neue uneinheitliche Werte. Auswahlfelder, Referenztabellen und geprüfte Adressstrukturen sind wirksamer als regelmäßige manuelle Großbereinigungen.
Änderungen mit hoher Wirkung erhalten Freigaben. Eine neue Artikelgruppe oder geänderte Kundenzuordnung kann Auswertungen, Preise und Buchhaltung beeinflussen.
APIs verbinden operative Datenflüsse
APIs eignen sich, wenn Anwendungen aktuelle Daten lesen oder Aktionen auslösen müssen. Eine angenommene Verkaufschance kann einen Auftrag anlegen; ein neues Ticket kann Kunden- und Anlagenkontext abrufen.
Die Integration überträgt nur erforderliche Felder. Ein Supportsystem benötigt vielleicht Vertragsstatus und zuständiges Team, aber keine vollständigen Umsätze oder Buchungsdetails.
Webhooks melden Änderungen zeitnah. Ein zusätzlicher periodischer Abgleich kann fehlende Ereignisse erkennen. Eindeutige IDs und idempotente Verarbeitung verhindern Dubletten.
Der Artikel API-Integration im Mittelstand beschreibt Planung, Fehlerbehandlung, Sicherheit und Betrieb dieser Verbindungen.
Dateiwege bleiben für Stapeldaten sinnvoll
Nicht jede Quelle stellt eine API bereit. Ein geregelter CSV-, XML- oder SFTP-Austausch kann für monatliche Abrechnung, nächtliche Stammdaten oder einmalige Migration wirtschaftlich sein.
Format, Zeichensatz, Spalten, Übertragungszeit und Fehlerantwort werden verbindlich definiert. Dateien erhalten eindeutige Namen und werden erst nach vollständigem Upload verarbeitet.
Ein Importbericht zeigt angenommene und abgelehnte Zeilen. Teilverarbeitung bleibt sichtbar. Wiederholte Dateien erzeugen keine doppelten Datensätze.
Unkontrollierte Tabellen per E-Mail sind dagegen kein belastbarer Integrationsweg. Version, Empfänger und Verarbeitung lassen sich nur schwer nachvollziehen.
Middleware koordiniert mehrere Datenquellen
Bei vielen Punkt-zu-Punkt-Verbindungen wächst die Abhängigkeit. Eine Änderung am ERP betrifft mehrere individuelle Schnittstellen. Monitoring und Fehlerbehandlung sind verteilt.
Middleware kann Authentifizierung, Mapping, Routing, Warteschlangen und Protokollierung zentral bereitstellen. Systeme kommunizieren über klarere Verträge und wiederverwendbare Komponenten.
Die Plattform darf nicht zur undokumentierten Sammlung aller Fachregeln werden. Regeln bleiben einem verantwortlichen Prozess oder Dienst zugeordnet. Änderungen werden versioniert und getestet.
Für wenige stabile Verbindungen kann direkte Integration einfacher sein. Middleware wird anhand Komplexität und Betriebsnutzen gewählt, nicht als Pflichtbestandteil jeder Datenstrategie.
Eine zentrale operative Datenbank ist selten der erste Schritt
Alle Systeme direkt auf eine gemeinsame Datenbank umzustellen klingt konsequent, erzeugt aber enge technische Kopplung. Unterschiedliche Anwendungen besitzen eigene Transaktionen, Sicherheitsmodelle und Updatezyklen.
Schreibzugriffe mehrerer Systeme auf dieselben Tabellen gefährden Konsistenz. Eine Anwendung kann Regeln umgehen, die eine andere voraussetzt. Herstellerupdates werden schwierig.
Besser ist häufig eine klare Datenverantwortung mit APIs oder Ereignissen. Gemeinsame Daten können in einem gezielt entwickelten Dienst geführt werden, wenn der Prozess dies rechtfertigt.
Eine zentrale Datenbank kann für eine neue individuelle Plattform sinnvoll sein. Sie ist jedoch Ergebnis einer Architekturentscheidung, nicht die pauschale Lösung für historisch gewachsene Silos.
Data Warehouse und Data Lake lösen analytische Silos
Operative Integration sorgt dafür, dass Geschäftsprozesse funktionieren. Analytische Integration führt Daten für Berichte und Entscheidungen zusammen. Beide Ziele benötigen unterschiedliche Architekturen.
Ein Data Warehouse übernimmt ausgewählte Daten aus Quellsystemen, harmonisiert Dimensionen und stellt definierte Kennzahlen bereit. Historische Stände können erhalten bleiben, ohne operative Systeme zu belasten.
Ein Data Lake kann größere Mengen unterschiedlicher Rohdaten aufnehmen. Ohne Katalog, Qualität, Berechtigungen und klare Anwendungsfälle wird er jedoch zum neuen unübersichtlichen Silo.
Berichte schreiben grundsätzlich nicht ungeprüft in operative Systeme zurück. Erkenntnisse können einen kontrollierten Prozess oder eine Aufgabe auslösen, aber die Systemverantwortung bleibt erhalten.
Ein semantisches Modell vereinheitlicht Kennzahlen
Umsatz, Auftragseingang, aktiver Kunde und offene Leistung müssen eindeutig definiert sein. Sonst zeigen mehrere Dashboards trotz identischer Quellen unterschiedliche Werte.
Das semantische Modell beschreibt Berechnung, Zeitraum, Filter und verantwortliche Quelle. Ein Auftrag kann bei Annahme zum Auftragseingang zählen; Umsatz entsteht möglicherweise erst mit Leistung oder Buchung. Diese Definition ist eine Geschäftsentscheidung.
Dimensionen wie Kunde, Standort, Produkt und Zeit werden über stabile Schlüssel verbunden. Änderungen an Hierarchien benötigen einen Umgang mit historischen Auswertungen.
Kennzahlen erhalten Eigentümer und Änderungsverfahren. Ein zentrales BI-Werkzeug allein beseitigt keine Definitionskonflikte.
Datenvirtualisierung kann Kopien vermeiden
Datenvirtualisierung stellt eine gemeinsame Sicht auf mehrere Quellen bereit, ohne alle Daten dauerhaft in einen neuen Speicher zu kopieren. Sie kann für aktuelle Abfragen und schrittweise Modernisierung nützlich sein.
Leistung und Verfügbarkeit hängen dann von den Quellsystemen ab. Eine komplexe Abfrage kann operative Anwendungen belasten. Berechtigungen müssen über Quellen hinweg korrekt wirken.
Die virtuelle Sicht löst keine schlechte Stammdatenqualität. Mapping, IDs und Begriffe bleiben erforderlich. Auch Aktualität und Herkunft müssen sichtbar sein.
Für wiederkehrende, umfangreiche Analysen kann ein replizierter analytischer Bestand geeigneter sein. Der Anwendungsfall entscheidet.
Datenkatalog und Herkunft schaffen Vertrauen
Ein Datenkatalog dokumentiert verfügbare Datensätze, Bedeutung, Eigentümer, Quelle, Aktualität und zulässige Verwendung. Er muss nicht mit einem großen Werkzeug beginnen; eine gepflegte strukturierte Übersicht kann den ersten Nutzen liefern.
Data Lineage beschreibt, wie ein Wert von der Quelle über Transformationen in Bericht oder Zielsystem gelangt. Bei einer unerwarteten Kennzahl kann das Team den Ursprung zurückverfolgen.
Technische Metadaten werden mit fachlichen Erklärungen verbunden. Ein Feldname wie customer_status erklärt nicht, wer ihn setzt und welche Entscheidung davon abhängt.
Der Katalog wird im Änderungsprozess aktualisiert. Eine einmalige Dokumentation verliert bei neuen Schnittstellen schnell ihre Verlässlichkeit.
Datenqualität wird konkret messbar
„Unsere Daten sind schlecht“ ist keine umsetzbare Diagnose. Für einen Prozess werden benötigte Qualitätsmerkmale definiert: Vollständigkeit, Eindeutigkeit, Gültigkeit, Aktualität und Konsistenz.
Eine Lieferadresse muss vor Versand vollständig und plausibel sein. Eine Telefonnummer kann für einen reinen E-Mail-Prozess optional bleiben. Qualitätsanforderungen folgen dem Zweck.
Digitalisierungs-Reifegrad
Wie digital ist Ihr Unternehmen wirklich? Score + Roadmap.
- Digitalisierungs-Score 0–100
- Reifegrad: Anfänger bis Digital Leader
- Priorisierte Roadmap
- Bericht per E-Mail
Prüfungen laufen möglichst bei der Entstehung. Fehler werden im führenden System korrigiert, nicht dauerhaft in jeder Schnittstelle separat repariert.
Qualitätsberichte zeigen häufige Ursachen und betroffene Prozesse. Persönliche Ranglisten aus Fehlern sind kein automatischer Bestandteil einer Dateninitiative.
Berechtigungen gelten auch im gemeinsamen Datenfluss
Dass ein Bericht Daten technisch zusammenführen kann, bedeutet nicht, dass jeder Nutzer alles sehen darf. Rollen, Mandanten, Standorte und Zwecke werden über die Architektur hinweg berücksichtigt.
Ein Integrationsdienst erhält minimale Zugriffe. Analytische Daten können aggregiert oder pseudonymisiert werden. Besonders schützenswerte Felder werden nur bei begründetem Bedarf übernommen.
Exporte sind ebenfalls Datenzugriffe. Download, Weitergabe und lokale Speicherung benötigen Regeln. Ein zentrales Dashboard kann sicher sein, während exportierte Tabellen neue Silos und Risiken erzeugen.
Eintritt, Rollenwechsel und Austritt werden systemübergreifend organisiert. Veraltete Konten dürfen nicht über alte Integrationszugänge weiterwirken.
Datenschutz folgt Zweck und Lebenszyklus
Beim Zusammenführen steigt die Möglichkeit, Profile und Zusammenhänge zu bilden. Deshalb werden Zweck, erforderliche Daten, Empfänger, Aufbewahrung und Löschung vor der Integration bewertet.
Datenminimierung gilt auch für zentrale Plattformen. Ein Data Warehouse benötigt nicht automatisch vollständige Notiztexte oder Dokumente, wenn aggregierte Kennzahlen ausreichen.
Lösch- und Sperrregeln berücksichtigen Quellsystem, Replikate, Backups und Berichte. Gesetzliche Aufbewahrung kann eine begrenzte weitere Speicherung bestimmter Belege verlangen, während operative Kontaktinformationen gelöscht werden.
Die konkrete rechtliche Gestaltung wird bei Bedarf mit zuständigen Fachstellen geprüft. Technische Zentralisierung erzeugt keine pauschale Rechtsgrundlage.
Migration braucht einen kontrollierten Schnitt
Beim Ablösen eines Silos werden aktive Daten, Historie und Archiv getrennt. Nicht jede alte Tabelle muss vollständig in das neue operative System gelangen.
Mapping und Bereinigung werden an Testmigrationen geprüft. Anzahl, Summen, Beziehungen und Stichproben zeigen, ob Daten vollständig und richtig interpretiert wurden.
Ein Delta-Abgleich übernimmt Änderungen zwischen Probelauf und Umstellung. Danach wird das alte System schreibgeschützt oder mit einem klaren Enddatum betrieben.
Rückfallweg und Abnahmekriterien stehen vor dem Go-live fest. Zwei dauerhaft beschreibbare Systeme würden das Silo lediglich verdoppeln.
Eine schrittweise Roadmap vermeidet die Großbaustelle
Zuerst werden Datenobjekte, Verantwortungen und der größte Prozessbruch geklärt. Ein begrenzter Datenfluss liefert früh Nutzen und erprobt IDs, Mapping, Monitoring und Fehlerweg.
Danach folgen abhängige Integrationen. Kundenzuordnung wird stabilisiert, bevor ein umfangreiches Dashboard darauf aufbaut. Artikel- und Auftragsdaten werden geklärt, bevor automatische Rechnungsübergaben entstehen.
Eine Zielarchitektur hält die Richtung fest, ohne alle Details vorwegzunehmen. Jede Etappe besitzt messbares Ergebnis und vermeidet neue Punktlösungen.
Erfolgreiche Übergaben werden als Muster dokumentiert. Authentifizierung, Protokollierung und Warteschlange können wiederverwendet werden.
Erfolg zeigt sich in Prozess und Entscheidung
Vor dem Projekt werden heutige Auswirkungen erfasst: Doppelerfassungen, Rückfragen, widersprüchliche Berichte, Suchzeit, Fehlerkorrekturen und Verzögerungen.
Nach der Umsetzung wird geprüft, ob Daten einmal entstehen, Übergaben zuverlässig laufen und Kennzahlen nachvollziehbar sind. Neue Pflege- und Monitoringaufgaben gehören in die Bewertung.
Technische Kennzahlen wie Fehlerrate und Aktualität ergänzen die Prozesswirkung. Ein fehlerfreier Datenstrom ist kein Erfolg, wenn er die falschen Daten liefert.
Die nächste Ausbaustufe folgt dem größten verbleibenden Engpass. Nicht jede verfügbare Quelle muss sofort angeschlossen werden.
SW Business Solutions baut einen verlässlichen Informationsfluss
SW Business Solutions analysiert Prozesse, Anwendungen, Datenobjekte und bestehende Exporte. Gemeinsam mit den Fachverantwortlichen werden führende Systeme, IDs, Begriffe, Qualitätsregeln und Berechtigungen festgelegt.
Über API-Entwicklung und Datenintegration verbindet SW Business Solutions Cloud- und lokale Systeme, entwickelt Integrationsdienste, Dateiwege, Webhooks, Warteschlangen und Monitoring. Bestehende Produkte werden genutzt, statt reflexartig ersetzt zu werden.
Wenn ein fehlender zentraler Prozessbaustein erforderlich ist, kann SW Business Solutions eine individuelle Daten- oder Fachanwendung entwickeln. Sie wird in die vorhandene Landschaft integriert und übernimmt eine klar definierte Verantwortung.
Als Einstieg genügt ein Vorgang, bei dem Mitarbeiter heute Daten suchen, vergleichen oder mehrfach übertragen. SW Business Solutions kann daraus eine Analyse der Datensilos und eine priorisierte Integrationsroadmap erstellen. Das gewünschte Ergebnis ist kein riesiger Sammelspeicher, sondern verlässliche Information am richtigen Prozessschritt.
Häufige Fragen
Was ist ein Datensilo im Unternehmen?
Wie lassen sich Datensilos technisch auflösen?
Müssen alle Daten in einer zentralen Datenbank liegen?
Was ist ein führendes System?
Welche Rolle spielt Datenqualität?
Wie unterstützt SW Business Solutions beim Auflösen von Datensilos?
Verwendete Technologien


Passende Leistungen
Beratung & Planung
Technische Beratung, Workshops und Requirements Engineering für Ihre Projekte. Wir unterstützen Sie bei der Planung und Umsetzung Ihrer digitalen Strategie.
Softwarearchitektur
Fundierte Architekturentscheidungen als Grundlage für skalierbare, wartbare und sichere Softwaresysteme.
API-Entwicklung
Entwicklung von RESTful APIs und GraphQL-Schnittstellen für die Integration verschiedener Systeme. Wir schaffen flexible und dokumentierte Schnittstellen für Ihre Anwendungen.