

Datenqualität verbessern: Grundlage erfolgreicher Digitalisierung
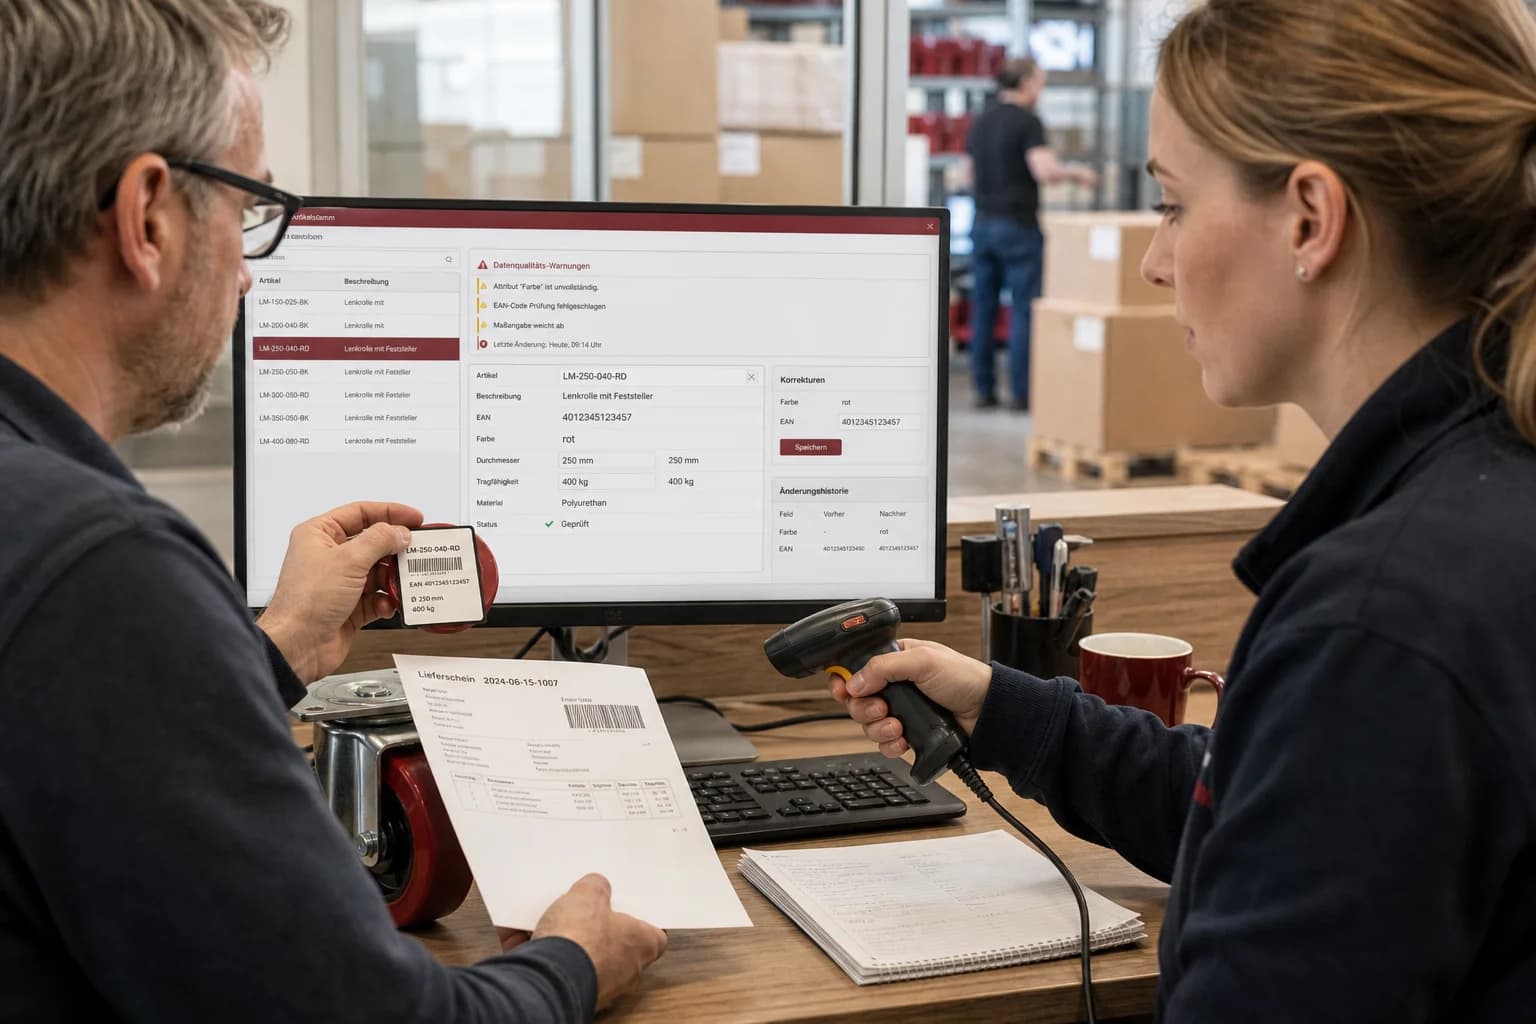

Datenqualität verbessern: Vollständigkeit, Eindeutigkeit, Gültigkeit und Aktualität messen, Fehlerursachen beheben und Daten dauerhaft pflegen.
Datenqualität verbessern: Grundlage erfolgreicher Digitalisierung
Das neue CRM zeigt mehrere Datensätze für denselben Kunden, im ERP fehlen Lieferadressen und ein Dashboard ordnet Umsätze einer unbekannten Produktgruppe zu. Die Systeme arbeiten technisch korrekt. Weil die Eingaben und Zuordnungen nicht verlässlich sind, skaliert die Digitalisierung bestehende Fehler. Unternehmen müssen Datenqualität verbessern, bevor Automatisierung und Analyse belastbare Ergebnisse liefern können.
Datenqualität bedeutet nicht, jeden historischen Datensatz perfekt zu bereinigen. Sie beschreibt, ob Daten für einen konkreten Zweck vollständig, gültig, eindeutig, konsistent und aktuell genug sind.
SW Business Solutions verbindet Qualitätsanalyse, Prozessverbesserung und technische Umsetzung. Validierungen, Stammdatenregeln, Integrationen und Klärungsoberflächen werden dort aufgebaut, wo sie den Geschäftsvorgang tatsächlich schützen.
Datenqualität wird am Verwendungszweck bewertet
Eine Telefonnummer kann für einen E-Mail-Newsletter optional sein, für einen telefonischen Rückrufprozess jedoch erforderlich. Eine Lieferadresse muss vor Versand korrekt sein, nicht zwingend bei einer frühen anonymen Anfrage.
Qualitätsanforderungen werden deshalb je Anwendungsfall definiert. Pauschale Vollständigkeitsquoten können wichtige und unwichtige Felder vermischen.
Der Prozess nennt den Zeitpunkt, an dem eine Angabe benötigt wird. Ein Wert kann zunächst freiwillig und vor Auftragserteilung verpflichtend sein.
Diese Zweckorientierung verhindert unnötige Pflichtfelder und konzentriert Bereinigung auf geschäftlich relevante Daten.
Schlechte Daten verursachen konkrete Prozesskosten
Fehlende Angaben erzeugen Rückfragen und verzögern Aufträge. Dubletten verteilen Kommunikation und Historie. Ungültige Artikelzuordnungen führen zu falschen Auswertungen oder Buchungsfehlern.
Mitarbeiter bauen Umgehungen: eigene Tabellen, Freitextnotizen und persönliche Adresslisten. Dadurch entstehen weitere Datenstände.
Die Kosten werden anhand realer Vorgänge erfasst: Korrekturzeit, Rücksendung, verzögerte Rechnung, manuelle Zuordnung oder verlorene Anfrage.
Der Nutzen einer Qualitätsmaßnahme wird gegen diese Wirkung bewertet, nicht gegen ein abstraktes Ideal.
Vollständigkeit prüft erforderliche Angaben
Eine Vollständigkeitsregel nennt Datenfeld, Prozessphase und Ausnahmen. Rechnungsadresse und Zahlungsbedingung können vor Auftragsfreigabe verpflichtend sein.
Ein leeres Feld ist nicht dasselbe wie „nicht zutreffend“ oder „noch unbekannt“. Diese Zustände werden getrennt modelliert, wenn sie fachlich relevant sind.
Pflichtfelder werden nicht pauschal bei der ersten Erfassung verlangt. Zu viele Eingaben führen zu Fantasiewerten oder Prozessabbrüchen.
Dashboards zeigen Vollständigkeit je Prozess und Quelle. Die Korrektur erfolgt beim zuständigen Datensatz.
Gültigkeit prüft Format und erlaubte Werte
E-Mail, Postleitzahl, Datum, Einheit und Artikelnummer besitzen formale Regeln. Eine syntaktisch gültige E-Mail muss dennoch nicht erreichbar sein.
Referenzlisten begrenzen Länder, Währungen, Produktgruppen oder Status. Freitext bleibt dort, wo neue oder besondere Inhalte erforderlich sind.
Plausibilitätsprüfungen berücksichtigen Zusammenhänge. Ein Enddatum vor dem Startdatum oder eine negative Menge kann unzulässig sein.
Warnung und harter Fehler werden unterschieden. Eine seltene, aber legitime Ausnahme darf nicht dauerhaft blockiert werden.
Eindeutigkeit verhindert konkurrierende Datensätze
Ein Kunde kann mehrfach angelegt werden, weil Schreibweise, Ansprechpartner oder Adresse abweichen. Eine einzelne E-Mail-Adresse ist nicht immer ein geeigneter Dublettenschlüssel.
Matching-Regeln kombinieren Merkmale und gewichten Sicherheit. Eindeutige Fälle können automatisch zugeordnet werden; unsichere Treffer erhalten eine fachliche Prüfung.
Zusammenführung bewahrt relevante Historie, Beziehungen und externe IDs. Sie darf nicht blind zwei tatsächlich verschiedene Niederlassungen verschmelzen.
Vor der Neuanlage unterstützt eine Suche oder Vorschlagsfunktion. Prävention ist günstiger als regelmäßige große Dublettenbereinigung.
Konsistenz verbindet Werte über Systeme
CRM und ERP können unterschiedliche Kundenadressen zeigen. Konsistenz bedeutet nicht, dass jedes Feld überall identisch sein muss. Fachliche Verantwortungen unterscheiden sich.
Für jedes Objekt und Feld wird ein führendes System benannt. Andere Anwendungen erhalten Daten über definierte Integrationen.
Abgleichsregeln erkennen widersprüchliche Referenzen, Status oder Summen. Die Korrektur folgt dem verantwortlichen System.
Der Artikel Datensilos technisch auflösen vertieft führende Systeme, IDs und gemeinsame Datenmodelle.
Aktualität richtet sich nach der Entscheidung
Eine Verfügbarkeit vor dem Verkauf muss sehr aktuell sein. Eine Kundensegmentierung kann in größeren Abständen genügen.
Jede Datenquelle erhält ein Aktualitätsziel. Pipelines zeigen letzten erfolgreichen Ladezeitpunkt und Alter einzelner Datensätze.
Ein vorhandener Wert kann veraltet sein, obwohl er formal vollständig und gültig ist. Adress-, Vertrags- oder Zuständigkeitsdaten benötigen Aktualisierungsereignisse.
Mitarbeiter dürfen nicht aus Gewohnheit jedes Feld in festen Abständen bestätigen müssen. Aktualisierung wird nach Risiko und Ereignis gestaltet.
Genauigkeit ist nicht vollständig automatisierbar
Ein System kann prüfen, ob eine Hausnummer vorhanden ist, aber nicht immer, ob der Kunde tatsächlich dort beliefert werden soll.
Externe Referenzdienste können Adressen oder Unternehmensdaten unterstützen. Ihre Quelle, Aktualität, Kosten und zulässige Nutzung werden geprüft.
Stichproben, Rückmeldungen aus Prozessen und Abgleich mit verlässlichen Belegen zeigen tatsächliche Genauigkeit.
Eine Zahl mit vielen Dezimalstellen ist nicht automatisch genauer. Einheit, Messmethode und Herkunft bleiben entscheidend.
Datenprofiling schafft einen belastbaren Ausgangspunkt
Vor der Bereinigung werden Felder und Werte untersucht: Nullanteil, eindeutige Werte, Formate, Ausreißer, Längen und häufige Kombinationen.
Profiling zeigt beispielsweise unterschiedliche Datumsformate, veraltete Kategorien oder viele ähnliche Firmennamen. Es liefert Hypothesen, keine automatische fachliche Bewertung.
Aktive Datensätze, Historie und Archiv werden getrennt betrachtet. Ein altes unvollständiges Archiv hat möglicherweise eine andere Priorität als offene Aufträge.
Der Ausgangsstand wird gespeichert, damit die Wirkung später messbar bleibt.
Qualitätsregeln werden maschinenlesbar und verständlich
Eine Regel nennt Objekt, Feld, Bedingung, Schweregrad, Eigentümer und Korrekturweg. Beispiel: Vor Freigabe eines Lieferauftrags muss eine gültige Lieferadresse vorliegen.
Technische Implementierung kann in Quellsystem, API, Datenpipeline oder Analyseplattform liegen. Die fachliche Definition bleibt unabhängig dokumentiert.
Regeln erhalten Versionen. Eine neue Pflichtangabe gilt ab einem bestimmten Prozessstand und darf historische Datensätze nicht unkontrolliert als Fehler markieren.
Ein Beispiel und Gegenbeispiel erleichtern Fachprüfung und Test.
Fehler werden möglichst bei der Entstehung verhindert
Auswahllisten, Vorschläge, Scans und Übernahme aus führenden Systemen reduzieren Tippfehler. Vorbelegung spart Arbeit, darf aber nicht blind bestätigt werden.
Die Benutzeroberfläche erklärt, warum eine Angabe benötigt wird und wie sie korrigiert werden kann. „Ungültige Eingabe“ ohne konkrete Hilfe verlagert das Problem.
Pflichtfelder erscheinen zum richtigen Zeitpunkt. Eine frühe Marketinganfrage benötigt weniger Angaben als ein verbindlicher Auftrag.
Systeme übertragen vorhandene Werte automatisch. Mitarbeiter sollen Daten nicht mehrfach eingeben müssen, nur um Qualität zu beweisen.
Freitext wird bewusst eingesetzt
Freitext ist wertvoll für neue Ursachen, individuelle Anforderungen und Kontext. Er ist ungeeignet als alleinige Grundlage für wiederkehrende Status, Produkte oder Verantwortlichkeiten.
Eine Kombination aus Kategorie und Erläuterung ermöglicht Auswertung und Detail. Kategorien werden gepflegt und nicht endlos erweitert.
KI kann Freitext klassifizieren oder Vorschläge machen. Das Ergebnis wird abhängig von Wirkung geprüft und nicht als sichere Wahrheit gespeichert.
Originaltext und abgeleitete Kategorie bleiben getrennt, damit Korrektur und Nachvollziehbarkeit möglich sind.
Stammdaten benötigen Eigentümer und Pflegeprozess
Kunde, Produkt, Standort und Organisation werden in vielen Vorgängen wiederverwendet. Fehler besitzen entsprechend große Wirkung.
Ein Data Owner entscheidet Definition und Qualitätsanforderungen. Ein Data Steward oder zuständiges Team bearbeitet Klärfälle und verbessert Regeln.
IT betreibt Systeme und Prüfungen, kann aber nicht allein entscheiden, ob zwei Gesellschaften fachlich zusammengehören.
Der geplante Artikel zum Stammdatenmanagement vertieft Rollen, Freigaben und technische Synchronisation.
Referenzdaten verhindern freie Varianten
Länder, Währungen, Einheiten, Branchen und Statuswerte sind Referenzdaten. Sie erhalten stabile Codes, verständliche Bezeichnungen und Gültigkeitszeiträume.
Mehrsprachige Namen ändern nicht den technischen Schlüssel. Veraltete Werte werden deaktiviert, nicht aus historischen Datensätzen gelöscht.
Eine Zuordnungstabelle kann alte Werte auf neue Kategorien abbilden. Änderungen an Hierarchien berücksichtigen historische Berichte.
Referenzdaten werden zentral veröffentlicht und über Schnittstellen verteilt, statt in jeder Anwendung unabhängig gepflegt.
Datenbereinigung braucht einen kontrollierten Plan
Bereinigung beginnt mit Priorität und Sicherung. Aktive Kunden, offene Aufträge und aktuelle Produkte werden vor einem großen Archiv bearbeitet.
Automatische Korrekturen sind nur bei eindeutigen Regeln zulässig. Unsichere Änderungen gehen in eine fachliche Arbeitsliste.
Vorher-Nachher-Protokolle und Stichproben belegen die Wirkung. Ein Rückfallweg schützt vor falsch zusammengeführten Datensätzen.
Bereinigung ohne Prävention ist kurzfristig. Der Erfassungs- und Integrationsprozess wird parallel verbessert.
Migration darf Fehler nicht blind übernehmen
Bei einem Systemwechsel werden aktive Daten, Historie und Archiv getrennt. Nicht jeder alte Freitextwert gehört in das neue operative Modell.
Mapping definiert Felder, Einheiten, Status und Beziehungen. Testmigrationen prüfen Anzahl, Summen und Stichproben.
Fehlerhafte Datensätze werden korrigiert, bewusst archiviert oder mit einem Klärstatus übernommen. Sie verschwinden nicht ohne dokumentierte Entscheidung.
Ein Delta-Abgleich erfasst Änderungen zwischen Testlauf und Go-live. Danach ist das führende System eindeutig.
Schnittstellen benötigen Qualitätskontrollen
Eine API prüft Schema, Pflichtfelder und fachliche Referenzen, bevor sie einen Vorgang annimmt. Fehlerantworten nennen stabile Codes und konkrete Felder.
Integrationen überwachen unbekannte IDs, Mappingfehler und ungewöhnliche Mengen. Wiederholungen dürfen keine Dubletten erzeugen.
Eine Nachricht in der Warteschlange gilt nicht als vollständig verarbeitet. Der fachliche Zielstatus wird zurückgemeldet.
SW Business Solutions entwickelt APIs und Datenintegrationen, die Qualitäts- und Fehlerwege sichtbar in den Prozess einbauen.
Datenqualitäts-Dashboards zeigen Handlungsbedarf
Eine Übersicht kann Fehlerquote, betroffene Objekte, Alter, Ursache und verantwortlichen Bereich zeigen. Der Schwerpunkt liegt auf geschäftlicher Wirkung.
Eine hohe Nullquote in einem unwichtigen Feld ist weniger kritisch als wenige fehlende Rechnungsadressen bei offenen Aufträgen.
Drilldowns führen zu korrigierbaren Datensätzen. Berechtigungen schützen personenbezogene und vertrauliche Inhalte.
Trends zeigen, ob Präventionsmaßnahmen wirken oder neue Fehlerquellen entstehen.
Automatisiertes Monitoring erkennt neue Qualitätsprobleme
Qualitätsregeln laufen nach einer Datenladung, bei einem Ereignis oder in einem festen Intervall. Sie prüfen nicht nur einzelne Felder, sondern auch Mengen, Beziehungen und Verteilungen.
Ein plötzlicher Rückgang neuer Aufträge kann auf einen ausgefallenen Import hinweisen. Eine ungewöhnlich hohe Zahl unbekannter Produktcodes kann nach einem Anbieterupdate entstehen.
Schwellen berücksichtigen normale Schwankung und Saison. Jeder Ausreißer wird zunächst als Prüfhinweis behandelt; nicht jede Anomalie ist ein Fehler.
Alarme enthalten betroffene Quelle, Zeitraum und mögliche Wirkung. Sie werden an Daten- und Prozessverantwortliche geroutet, nicht pauschal an alle Nutzer.
Regeln und Schwellen werden versioniert. Nach einer bestätigten Ursache wird geprüft, ob Prävention, Mapping oder Überwachung verbessert werden kann.
Datenverträge machen Änderungen früh sichtbar
Ein Datenvertrag beschreibt Felder, Typen, Bedeutung, Pflicht, erlaubte Werte, Aktualität und Verantwortliche zwischen Quelle und Verbraucher.
Ändert ein Quellsystem einen Status oder entfernt ein Feld, kann ein Vertragstest die Abweichung vor dem produktiven Bericht erkennen. Eine rein technische Schemaprüfung entdeckt jedoch keine still geänderte Bedeutung.
Nicht kompatible Änderungen erhalten neue Version und Übergangszeit. Verbraucher werden zugeordnet und getestet, bevor die alte Struktur entfällt.
Der Vertrag gilt auch für strukturierte Dateien und manuelle Uploads. Dateiname und Gewohnheit ersetzen keine dokumentierte Schnittstelle.
Diese Vereinbarung reduziert gegenseitige Schuldzuweisungen. Quelle und Verbraucher wissen, welche Qualität geliefert, geprüft und bei Fehlern korrigiert wird.
Ein Datenqualitätsaudit priorisiert statt nur zu zählen
Ein Audit verbindet Profiling, Prozessbeobachtung, Verantwortlichkeiten und technische Datenflüsse. Es betrachtet aktive Geschäftsdaten und deren Wirkung, nicht nur die Gesamtzahl leerer Felder.
Digitalisierungs-Reifegrad
Wie digital ist Ihr Unternehmen wirklich? Score + Roadmap.
- Digitalisierungs-Score 0–100
- Reifegrad: Anfänger bis Digital Leader
- Priorisierte Roadmap
- Bericht per E-Mail
Die Prüfung verfolgt Stichproben von der Erfassung bis zu Auftrag, Bericht oder Automatisierung. Dadurch werden Fehlerursachen wie unklare Oberfläche, fehlende Schnittstelle oder widersprüchliche Definition sichtbar.
Risiken werden nach Prozessfolge, Häufigkeit, Korrekturaufwand und Schutzbedarf priorisiert. Eine fehlende optionale Notiz bleibt hinter einer falschen Rechnungszuordnung zurück.
Das Ergebnis ist ein Maßnahmenplan mit Eigentümer, Prävention, Bereinigung und Messgröße. Ein Audit ohne Umsetzungspfad wäre lediglich eine Mängelliste.
Klärfälle brauchen eine Arbeitsoberfläche
Unsichere Dubletten, unbekannte Artikel und widersprüchliche Adressen benötigen menschliche Entscheidung. Eine technische Fehlerliste allein reicht nicht.
Die Oberfläche zeigt Quelle, betroffene Beziehungen, Vorschlag und mögliche Folgen. Nutzer können korrigieren, zuordnen oder begründet als Ausnahme bestätigen.
Entscheidungen werden protokolliert und fließen in Regeln zurück. Wiederkehrende Ursachen werden systematisch behoben.
Bei besonderen Prozessen kann SW Business Solutions eine individuelle Datenqualitäts- und Klärungsanwendung entwickeln.
Qualitätskennzahlen dürfen keine falschen Anreize setzen
Wenn Teams nur an möglichst wenigen Fehlern gemessen werden, können sie schwierige Fälle vermeiden oder als Ausnahme deklarieren.
Kennzahlen werden mit Prozesswirkung und Fehlerursache verbunden. Systemdesign, Schulung und Datenquelle werden ebenso betrachtet wie manuelle Eingabe.
Persönliche Ranglisten sind kein automatischer Bestandteil. Zweck, Transparenz und Beteiligungsrechte werden gesondert geklärt.
Ziel ist ein verlässlicher Prozess, nicht eine scheinbar fehlerfreie Statistik.
Data Governance hält Regeln dauerhaft wirksam
Governance legt Rollen, Standards, Freigaben, Qualität, Zugriff und Lebenszyklus fest. Sie soll Entscheidungen beschleunigen, nicht jede kleine Änderung bürokratisieren.
Gemeinsame Kunden- oder Produktdefinitionen benötigen mehr Abstimmung als eine lokale Hilfsspalte. Entscheidungen werden nach Wirkung gestaffelt.
Regeländerungen werden auf Integrationen, Berichte und Prozesse geprüft. Ein Datenkatalog dokumentiert Eigentümer und Gültigkeit.
Fachliche und technische Verantwortungen bleiben getrennt, aber verbunden.
Datenschutz profitiert von guter Datenqualität
Unklare Dubletten und unbekannte Kopien erschweren Auskunft, Löschung und Zugriffskontrolle. Eindeutige IDs und Dateninventar schaffen Nachvollziehbarkeit.
Qualität bedeutet jedoch nicht, mehr personenbezogene Daten zu sammeln. Datenminimierung bleibt ein eigenes Ziel.
Lösch- und Sperrregeln berücksichtigen Quellen, Zielsysteme, Analysebestände und Backups. Aufbewahrungspflichten werden pro Datenart geprüft.
Die konkrete rechtliche Gestaltung wird bei Bedarf fachkundig begleitet.
KI benötigt kontrollierte Eingabe- und Ergebnisdaten
Modelle und KI-Assistenten können fehlerhafte oder veraltete Daten überzeugend weiterverarbeiten. Die Ausgabe wirkt dann präzise, obwohl die Grundlage nicht stimmt.
Trainings-, Kontext- und Ergebnisdaten erhalten Herkunft, Aktualität und Qualitätsprüfung. Besonders kritische Entscheidungen benötigen menschliche Freigabe.
KI kann bei Dublettenvorschlägen, Klassifikation und Anomalieerkennung unterstützen. Unsichere Treffer bleiben als Vorschlag gekennzeichnet.
Nicht jedes Qualitätsproblem benötigt KI. Referenzlisten und klare Pflichtlogik sind häufig verständlicher.
Ein Verbesserungsprogramm startet mit einem Prozess
Der erste Umfang ist beispielsweise Kunde bis Auftrag oder Artikel bis Rechnung. Relevante Datenfelder und Fehlerfolgen werden erfasst.
Profiling liefert den Ausgangsstand. Regeln, Eigentümer und Korrekturweg werden festgelegt. Erfassungsoberfläche und Integration werden verbessert.
Nach einer begrenzten Bereinigung misst das Unternehmen neue Fehler, Korrekturzeit und Prozesswirkung.
Erfolgreiche Muster werden auf weitere Datenobjekte übertragen. Eine zentrale Großbereinigung ohne Prozessbezug wird vermieden.
Erfolg zeigt sich in weniger Klärarbeit und stabileren Prozessen
Relevante Messgrößen sind Rückfragen, abgelehnte Übergaben, Dubletten, Korrekturzeit, verspätete Rechnungen und Datenabdeckung.
Die Quote allein genügt nicht. Wenige kritische Fehler können mehr Wirkung haben als viele harmlose Lücken.
Neue Pflegearbeit wird einbezogen. Eine Qualitätsregel darf nicht mehr Aufwand erzeugen, als sie im Prozess verhindert.
Regeln werden angepasst, wenn Geschäftsmodell oder Systeme sich ändern.
SW Business Solutions verbindet Datenqualität und Softwareprozess
SW Business Solutions analysiert einen konkreten Datenfluss, profiliert relevante Bestände und identifiziert Ursachen in Erfassung, Schnittstelle und Verantwortlichkeit.
Das Team entwickelt Validierungen, Referenzdaten, APIs, Dublettenlogik, Dashboards und Klärungsoberflächen. Bestehende CRM-, ERP- und Fachsysteme bleiben führend, soweit sie passend sind.
Das gewünschte Ergebnis ist kein abstrakter Qualitätswert. Mitarbeiter erfassen Daten einmal korrekt, fehlerhafte Übergaben bleiben sichtbar und Auswertungen zeigen einen nachvollziehbaren Stand.
Als Einstieg genügt ein Prozess, in dem heute regelmäßig Daten nachgefragt oder korrigiert werden. SW Business Solutions kann daraus eine Datenqualitätsanalyse mit priorisiertem Verbesserungsplan erstellen.
Häufige Fragen
Was bedeutet Datenqualität?
Wie lässt sich Datenqualität messen?
Wie verbessert ein Unternehmen seine Datenqualität?
Wie werden Dubletten vermieden?
Müssen alle historischen Daten bereinigt werden?
Wie unterstützt SW Business Solutions bei Datenqualität?
Verwendete Technologien


Passende Leistungen
Beratung & Planung
Technische Beratung, Workshops und Requirements Engineering für Ihre Projekte. Wir unterstützen Sie bei der Planung und Umsetzung Ihrer digitalen Strategie.
Softwarearchitektur
Fundierte Architekturentscheidungen als Grundlage für skalierbare, wartbare und sichere Softwaresysteme.
API-Entwicklung
Entwicklung von RESTful APIs und GraphQL-Schnittstellen für die Integration verschiedener Systeme. Wir schaffen flexible und dokumentierte Schnittstellen für Ihre Anwendungen.