

Dokumentenverarbeitung mit KI: Rechnungen, Verträge und Formulare auslesen
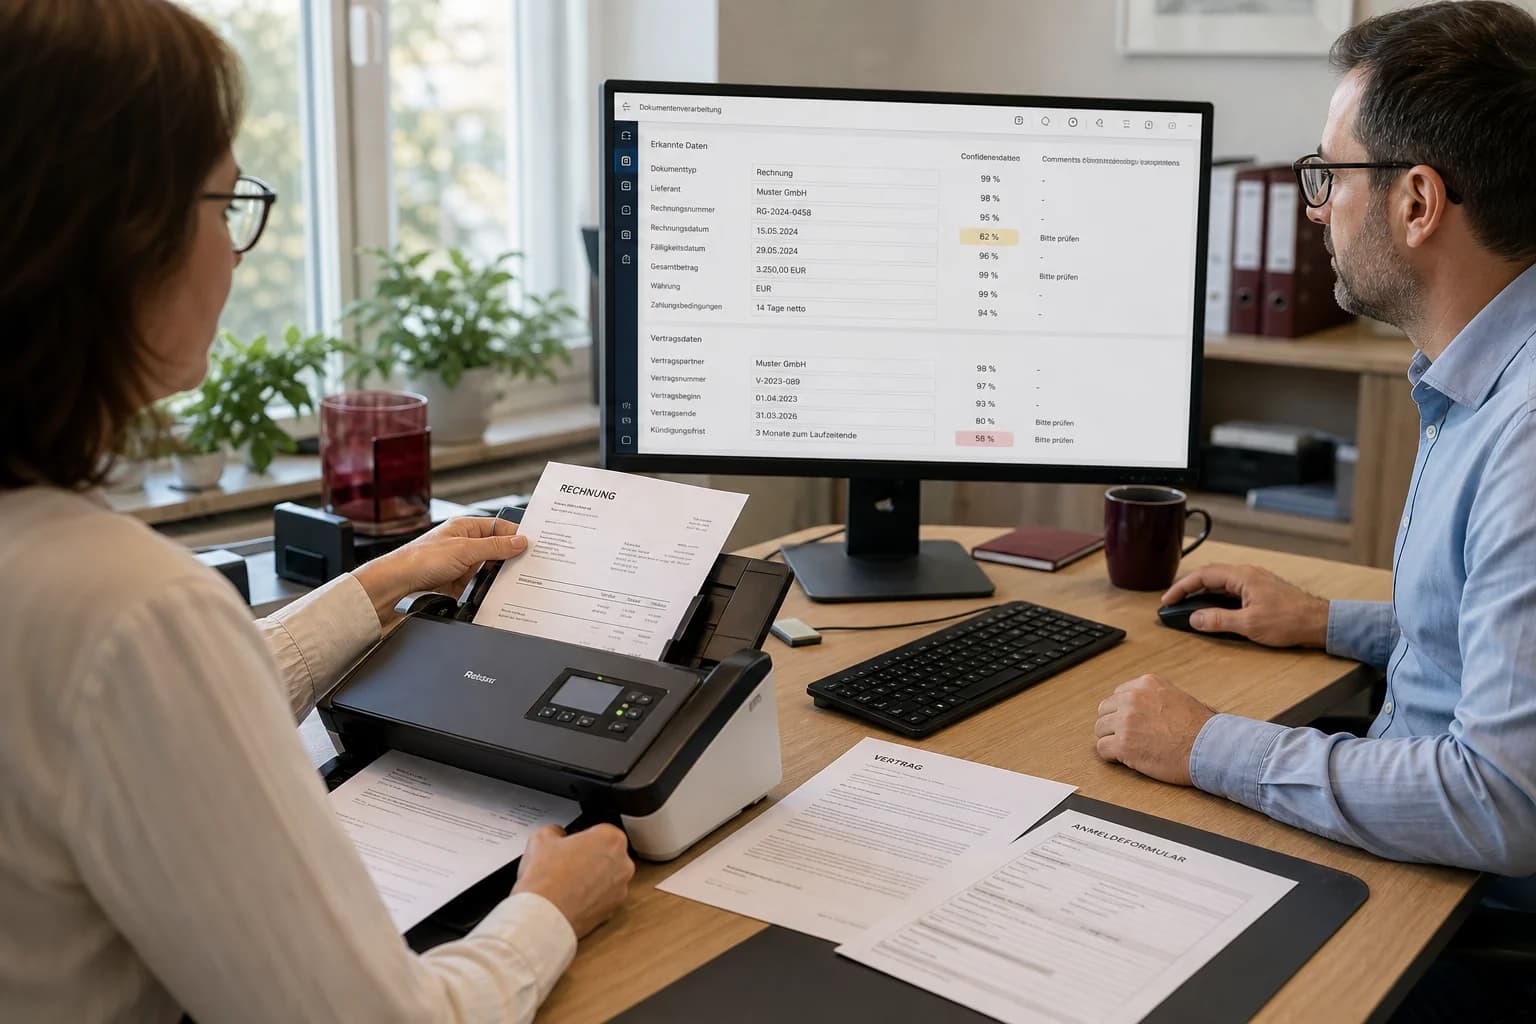

Dokumentenverarbeitung mit KI: Rechnungen, Verträge und Formulare auslesen, Ergebnisse prüfen und Daten sicher an DMS, ERP und CRM übergeben.
Dokumentenverarbeitung mit KI: Rechnungen, Verträge und Formulare auslesen
Eine Rechnung kommt als PDF per E-Mail, ein Vertrag liegt als Scan im Projektordner und ein ausgefülltes Formular wird als Smartphone-Foto weitergeleitet. Mitarbeiter öffnen jede Datei, suchen dieselben Angaben und übertragen sie in ERP, CRM oder Dokumentenmanagement. Genau hier setzt die Dokumentenverarbeitung mit KI an: Sie erkennt den Dokumenttyp, liest relevante Inhalte aus, prüft die Ergebnisse gegen Geschäftsregeln und bereitet die Übergabe an das führende System vor.
Der entscheidende Schritt ist nicht die Texterkennung. Ein kopierter Textblock spart wenig Arbeit, wenn Lieferant, Vertragsfrist oder Kundennummer danach erneut gesucht und manuell zugeordnet werden müssen. Eine tragfähige Lösung erzeugt strukturierte, überprüfbare Daten und weiß, wann ein Dokument zur Kontrolle an einen Menschen gehört.
Was Dokumentenverarbeitung mit KI tatsächlich bedeutet
Im Markt werden OCR, Intelligent Document Processing und generative KI häufig vermischt. Sie lösen unterschiedliche Aufgaben.
| Verfahren | Liefert | Typischer Einsatz | Grenze |
|---|---|---|---|
| OCR | Zeichen und Textpositionen | gescannte Seiten durchsuchbar machen | versteht die fachliche Bedeutung eines Feldes nicht zuverlässig |
| Layout-Analyse | Absätze, Tabellen, Auswahlfelder und Seitenstruktur | Formulare, Berichte und komplexe Tabellen zerlegen | ordnet die Ergebnisse noch keinem Geschäftsprozess zu |
| trainierter Extraktor | festgelegte Felder für bekannte Dokumenttypen | Rechnungsnummer, Vertragspartei oder Schadennummer auslesen | benötigt geeignete Modelle, Beispiele oder Konfiguration |
| Sprach- oder multimodales Modell | Inhalte kontextbezogen einordnen und in ein Schema übertragen | variable Verträge, freie Anschreiben oder uneinheitliche Formulare | kann plausible, aber falsche Angaben erzeugen |
| Regelwerk | Formate, Stammdaten und fachliche Bedingungen prüfen | IBAN, Datum, Lieferant, Pflichtfeld oder Wertgrenze validieren | erkennt nur vorher definierte Regeln |
Microsoft beschreibt für Azure Document Intelligence die Extraktion von Text, Tabellen, Auswahlmarken und Dokumentstruktur. Amazon Textract unterscheidet bei der Analyse Text, Formulare, Tabellen, Abfrageergebnisse und Signaturen. Google Document AI trennt seine Prozessoren nach Digitalisierung, Extraktion, Klassifikation und Aufteilung von Dokumenten. Diese Produktlogiken zeigen denselben Grundsatz: Dokumentenverarbeitung besteht aus mehreren getrennten Verarbeitungsschritten, nicht aus einem einzigen KI-Aufruf.
Ein Large Language Model kann diese Schritte ergänzen. Es ersetzt weder die Originaldatei noch Stammdaten, Berechtigungen und fachliche Prüfregeln. Wer alle Aufgaben in einen freien Prompt legt, erhält eine schwer prüfbare Blackbox.
Welche Dokumente sich für KI-gestützte Verarbeitung eignen
Ein geeigneter Vorgang kommt wiederholt vor, enthält erkennbare Zielfelder und endet in einem definierten Systemzustand. Dazu gehören beispielsweise:
- Eingangsrechnungen mit Lieferant, Rechnungsnummer, Datum, Positionen und Beträgen
- Verträge mit Parteien, Laufzeit, Kündigungsfrist, Leistungsumfang und Anlagen
- Kunden-, Schaden- oder Serviceformulare mit Kontakt- und Vorgangsdaten
- Bestellungen, Lieferscheine und Auftragsbestätigungen
- Bewerbungsunterlagen mit ausdrücklich festgelegtem und rechtlich geprüftem Verwendungszweck
- Prüfberichte, Protokolle und Wartungsnachweise
- freie Anschreiben, die einem bestehenden Vorgang zugeordnet werden sollen
Nicht jeder Dokumentenbestand ist ein guter Startpunkt. Seltene Einzelfälle, stark beschädigte Scans oder Unterlagen ohne klaren Folgeprozess erzeugen schnell mehr Prüfaufwand als Nutzen. Dasselbe gilt, wenn das Zielsystem keine saubere Schnittstelle besitzt oder niemand festgelegt hat, welche Quelle bei einem Widerspruch führt.
Der Artikel Geschäftsprozesse analysieren zeigt, wie Eingaben, Bearbeitungsschritte, Entscheidungen und Ergebnisse vor einer Automatisierung erfasst werden. Für Dokumente ist diese Vorarbeit besonders wichtig: Ein Feld wird nicht ausgelesen, weil es vorhanden ist, sondern weil ein nachfolgender Prozess es benötigt.
Der vollständige Ablauf vom Posteingang bis zum Zielsystem
Eine belastbare Dokumenten-Pipeline lässt sich in klar überprüfbare Stationen zerlegen.
1. Eingang erfassen
Dateien kommen aus E-Mail-Postfach, Uploadportal, Scanner, App, Netzlaufwerk oder einer Schnittstelle. Bereits hier werden Quelle, Empfangszeit, Absender und technischer Dateityp protokolliert. Die Originaldatei erhält eine eindeutige Kennung und bleibt unverändert erhalten.
2. Datei technisch prüfen
Das System prüft, ob die Datei geöffnet werden kann, ob Seiten fehlen, ob ein Passwortschutz vorliegt und ob der Inhalt überhaupt lesbar ist. Schadsoftware-Prüfung und Größenbegrenzung gehören vor die KI-Verarbeitung, nicht dahinter.
3. Dokumente trennen und klassifizieren
Ein PDF kann mehrere Rechnungen enthalten; ein Antrag kann aus Hauptformular und Anlagen bestehen. Die Klassifikation bestimmt Dokumenttyp, Mandant, Prozess und zuständige Verarbeitung. Unsichere Ergebnisse landen in einer Trenn- oder Zuordnungsmaske.
4. Text und Layout erkennen
OCR ermittelt Wörter und Positionen. Die Layout-Analyse identifiziert Tabellen, Überschriften, Auswahlfelder, Seitenzahlen und zusammengehörige Bereiche. Die Azure-Dokumentation zum Layout-Modell beschreibt dafür unter anderem Text, Tabellen, Auswahlmarken und hierarchische Struktur.
5. Fachliche Felder extrahieren
Aus dem erkannten Inhalt entsteht ein definiertes Schema. Eine Rechnung könnte beispielsweise Lieferanten-ID, Belegnummer, Netto-, Steuer- und Bruttobetrag enthalten. Bei einem Vertrag sind Vertragsparteien, Beginn, Mindestlaufzeit, Verlängerung, Kündigungsfrist und verantwortliche Stelle relevant.
6. Werte normalisieren
Datumsangaben werden in ein einheitliches Format überführt, Beträge erhalten Währung und Dezimaltrennzeichen, Adressen werden zerlegt und Artikelnummern gegen erlaubte Muster geprüft. Der ursprüngliche Wert bleibt für die Nachvollziehbarkeit erhalten.
7. Fachlich validieren
Jetzt werden Stammdaten, Summen, Pflichtfelder, Dubletten und Prozessregeln geprüft. Ein erkannter Lieferantenname reicht nicht, wenn im ERP zwei Gesellschaften mit ähnlicher Bezeichnung existieren. Das System benötigt eine eindeutige Zuordnung oder eine kontrollierte Rückfrage.
8. Ausnahme behandeln oder freigeben
Felder mit zu geringer Sicherheit, widersprüchliche Angaben und risikoreiche Aktionen gehen an eine zuständige Rolle. Die Prüfansicht zeigt Originalausschnitt, erkannten Wert, normalisierten Wert und verletzte Regel gemeinsam.
9. Daten und Dokument übergeben
Erst nach den erforderlichen Prüfungen werden Datensatz, Datei und Protokoll an DMS, ERP, CRM, Buchhaltung oder Fachanwendung übertragen. Der Status wird zurückgeschrieben, damit keine stille zweite Verarbeitung entsteht.
Die Workflow-Automatisierung für KMU ordnet solche Übergaben in Rollen, Status und Eskalationen ein. Die KI liefert Daten; der Workflow steuert, was damit geschehen darf.
Eingangsqualität entscheidet über den Prüfaufwand
Ein modernes Modell kann schiefe Fotos und uneinheitliche Layouts verarbeiten. Daraus folgt nicht, dass jede Aufnahme wirtschaftlich brauchbar ist. Schatten über einem Betrag, abgeschnittene Seitenränder oder eine zu starke Komprimierung können genau das Feld beschädigen, das den Vorgang entscheidet.
Vor der Extraktion sollte die Pipeline deshalb technische Merkmale prüfen:
- Auflösung und Lesbarkeit
- Drehung und Perspektive
- abgeschnittene Seiten oder überdeckte Bereiche
- Handschrift und Stempel über relevantem Text
- mehrseitige Vollständigkeit
- eingebetteter Text gegenüber reinem Bild
- Barcode oder QR-Code als zusätzliche Zuordnung
- Sprache und Zeichensatz
Eine schlechte Datei darf nicht mit einem scheinbar vollständigen Ergebnis weiterlaufen. Das System kennzeichnet die Ursache und fordert eine bessere Vorlage an oder leitet zur manuellen Erfassung weiter. Google nennt für Enterprise Document OCR ausdrücklich eine Qualitätsanalyse zur Lesbarkeit. Eine solche Vorprüfung ist kein kosmetischer Zusatz, sondern schützt die nachfolgenden Regeln vor unbemerkten Eingabefehlern.
Ein Extraktionsschema übersetzt Dokumente in Geschäftsbegriffe
„Lies dieses Dokument aus“ ist keine ausreichende Spezifikation. Die Lösung benötigt pro Dokumenttyp ein Schema mit Feldname, Datentyp, Pflichtstatus, erlaubten Formaten und fachlicher Bedeutung.
KI-Readiness-Check
Sind Sie bereit für Künstliche Intelligenz? Score + persönlicher Fahrplan.
- KI-Readiness-Score 0–100
- Ihre Stärken und Lücken
- Konkrete KI-Use-Cases für Sie
- Bericht per E-Mail in Minuten
Für einen Vertrag könnte ein Ausschnitt so aussehen:
| Feld | Datentyp | Prüfung | Folgeaktion |
|---|---|---|---|
| Vertragspartner | Referenz | Abgleich gegen Kunden- oder Lieferantenstamm | Datensatz zuordnen |
| Vertragsbeginn | Datum | plausibler Zeitraum | Laufzeit berechnen |
| Kündigungsfrist | Dauer und Bezugspunkt | Textstelle muss angegeben sein | Wiedervorlage erzeugen |
| automatische Verlängerung | Ja/Nein plus Zeitraum | Klauselstelle belegen | Fristüberwachung aktivieren |
| Verantwortlicher | interne Rolle | gültiger Mitarbeiter oder Bereich | Aufgabe zuweisen |
Jeder extrahierte Wert sollte auf die Fundstelle im Original verweisen. Bei Tabellen gehören Seite, Zeile und Spalte dazu; bei Fließtext ein Textausschnitt oder eine Position. Eine reine JSON-Antwort ohne Herkunft erschwert jede fachliche Prüfung.
Rechnungen auslesen: Zahlen brauchen mehr als Erkennung
Bei Rechnungen sind Kopf- und Positionsdaten stark strukturiert. Deshalb existieren vortrainierte Rechnungsmodelle. Trotzdem entscheidet die Validierung über den Nutzen.
Ein belastbarer Ablauf prüft unter anderem:
- Passt der erkannte Lieferant zu einem freigegebenen Stammdatensatz?
- Wurde dieselbe Rechnungsnummer für diesen Lieferanten bereits verarbeitet?
- Stimmen Netto, Steuer und Brutto rechnerisch zusammen?
- Bezieht sich die Rechnung auf Bestellung, Wareneingang oder Vertrag?
- Ist die angegebene Bankverbindung bekannt oder wurde sie geändert?
- Welche Kostenstelle, Bestellung oder Freigaberolle ist zuständig?
Der bereits geplante Serienartikel zur automatisierten Rechnungsverarbeitung vertieft OCR, Freigaben und Buchhaltungsübergabe separat. Hier bleibt die Rechnung ein Beispiel für die allgemeine Dokumenten-Pipeline. Dadurch konkurrieren die Artikel nicht um dieselbe Suchintention.
Verträge auslesen: Fundstelle und Auslegung trennen
Verträge sind schwieriger als Rechnungen, weil dieselbe Aussage sprachlich unterschiedlich formuliert sein kann. Eine Klausel zur Verlängerung kann im Haupttext, in einer Anlage oder in einem Nachtrag stehen. Das System muss Dokumente zusammenhalten und Widersprüche sichtbar machen.
KI kann:
- Parteien und Vertragsgegenstand vorschlagen
- Laufzeit- und Fristangaben mit Fundstelle extrahieren
- Klauseltypen klassifizieren
- Abweichungen von einer internen Vorlage markieren
- eine strukturierte Zusammenfassung für die Prüfung erzeugen
Sie sollte eine juristische Entscheidung nicht als feststehendes Ergebnis ausgeben. Besonders bei Haftung, Kündigung, Leistungsänderung und Vorrang von Anlagen bleibt die fachliche oder rechtliche Prüfung notwendig. Der sichere Zielzustand lautet nicht „Vertrag automatisch verstanden“, sondern „relevante Stellen vollständig gefunden, strukturiert vorgelegt und einer verantwortlichen Person zugewiesen“.
Formulare auslesen: Pflichtfelder, Auswahlmarken und Freitext verbinden
Formulare wirken einfach, enthalten aber häufig handschriftliche Ergänzungen, angekreuzte Optionen und mehrdeutige Feldbezeichnungen. Layout-Modelle können Auswahlmarken und Schlüssel-Wert-Beziehungen erkennen. Die Anwendung muss daraus einen gültigen Vorgang bauen.
Ein Serviceformular kann Kontaktdaten, Standort, Gerätetyp, Fehlerbeschreibung und gewünschte Reaktionszeit enthalten. Fehlt die Seriennummer, wird der Vorgang nicht verworfen. Er erhält den Status „Rückfrage erforderlich“ und eine vorbereitete Nachricht. Ist ein sicherheitskritisches Auswahlfeld markiert, wird eine andere Priorität gesetzt.
Die Prozessoptimierung mit KI zeigt weitere Einsatzfelder für die Verbindung von unstrukturierten Eingaben und festen Geschäftsregeln.
Prüfgrenzen nach Feldrisiko statt nach einem Gesamtscore
Viele Dienste geben Konfidenzwerte für erkannte Wörter oder Felder aus. Ein globaler Schwellenwert ist zu grob. Ein falsch erkanntes optionales Bemerkungsfeld hat eine andere Folge als eine falsche IBAN, Kündigungsfrist oder Dosierungsangabe.
Für jedes Zielfeld sollten vier Entscheidungen feststehen:
- Darf der Wert ohne Prüfung übernommen werden?
- Welche Regel oder Stammdatenquelle muss ihn bestätigen?
- Welche Rolle prüft einen unsicheren Wert?
- Was passiert, wenn innerhalb der vorgesehenen Zeit niemand entscheidet?
Eine praktikable Matrix unterscheidet:
| Risiko | Beispiel | Automatische Aktion |
|---|---|---|
| niedrig | interne Dokumentkategorie | übernehmen und protokollieren |
| mittel | Ansprechpartner oder Projektbezug | gegen Stammdaten prüfen |
| hoch | Betrag, Bankverbindung oder Vertragsfrist | Vier-Augen-Prüfung oder harte Regel |
| nicht automatisierbar | rechtliche Auslegung oder Sicherheitsentscheidung | zuständige Fachrolle entscheidet |
Die Qualitätskontrolle misst anschließend nicht nur „Dokument erfolgreich verarbeitet“. Sie betrachtet Feldgenauigkeit, Korrekturen, unerkannte Pflichtfelder und die fachliche Folge eines Fehlers.
DMS, ERP und CRM ohne Medienbruch anbinden
Extrahierte Daten sind erst wertvoll, wenn sie im richtigen System ankommen. Die Systemintegration im Mittelstand erklärt, wie führende Systeme und Datenflüsse festgelegt werden.
Für die Dokumentenverarbeitung bedeutet das:
- Das DMS führt Originaldatei, Version, Aufbewahrung und Berechtigung.
- Das ERP führt Lieferant, Bestellung, Buchung oder Auftrag.
- Das CRM führt Kunde, Kontakt, Verkaufschance und Kommunikation.
- Das Fachsystem führt den eigentlichen Fall, etwa Schaden, Antrag oder Serviceeinsatz.
- Die Automatisierungsplattform führt technischen Ablauf, Wiederholungsversuche und Fehlerstatus.
Über eine API-Entwicklung werden gezielte Lese- und Schreiboperationen bereitgestellt. Ein Zugriff „Lieferant anhand Steuernummer suchen“ ist leichter zu prüfen als ein allgemeiner Vollzugriff auf das ERP.
Für überschaubare Orchestrierungen kann n8n Eingang, Analyse, Prüfmaske und Übergabe verbinden. Komplexe Bereinigung oder eigene Modelle lassen sich beispielsweise mit Python umsetzen. Entscheidend ist nicht die Zahl der eingesetzten Werkzeuge, sondern ein konsistenter Vorgangsstatus über alle Komponenten.
Sicherheit und Datenschutz beginnen vor dem Modellaufruf
Rechnungen enthalten Bank- und Kontaktdaten, Verträge können Geschäftsgeheimnisse enthalten, Formulare zusätzlich besondere Kategorien personenbezogener Daten. Vor der Auswahl eines Dienstes müssen Datenarten, Zweck, Rechtsgrundlage, Empfänger, Speicherorte, Löschfristen und technische Schutzmaßnahmen feststehen.
Praktisch bedeutet das:
- nur erforderliche Seiten und Felder an einen Analysedienst übertragen
- Testdaten anonymisieren oder synthetisch erzeugen
- Mandanten und Berechtigungen technisch trennen
- Übertragung und Speicherung verschlüsseln
- Protokolle von unnötigen Dokumentinhalten freihalten
- Dateien und Zwischenergebnisse nach festgelegten Fristen löschen
- Auftragsverarbeitung und Unterauftragnehmer prüfen
- Zugriffe, Korrekturen und Exporte revisionsfähig protokollieren
Bei externen Modell-APIs müssen die konkreten Datenkontrollen je Produkt und Endpunkt geprüft werden. OpenAI dokumentiert beispielsweise, dass API-Inhalte standardmäßig nicht zum Training genutzt werden, sofern der Kunde nicht aktiv zustimmt; zugleich unterscheiden sich Aufbewahrung und Zero-Data-Retention-Eignung nach Endpunkt und Funktion. Maßgeblich ist die aktuelle Dokumentation zu API-Datenkontrollen, nicht eine pauschale Aussage über den Anbieter.
Der Europäische Datenschutzausschuss betont bei KI-Modellen eine fallbezogene Prüfung von Rechtsgrundlage, Erforderlichkeit, Betroffenenerwartung und Schutzmaßnahmen. Seine Stellungnahme zu KI-Modellen und DSGVO ersetzt keine Prüfung des konkreten Dokumentenprozesses, gibt aber die Richtung vor.
Auch die Einstufung nach der europäischen KI-Verordnung hängt vom Verwendungszweck ab. Das Auslesen eines Lieferscheins ist anders zu bewerten als eine KI-gestützte Entscheidung über Beschäftigung, Kreditwürdigkeit oder Zugang zu wesentlichen Leistungen. Die Verordnung (EU) 2024/1689 und die DSGVO gelten nebeneinander. Unternehmen sollten die konkrete Anwendung mit Datenschutz- und gegebenenfalls Rechtsberatung einordnen.
Kosten entstehen in Verarbeitung, Integration und Kontrolle
Die Rechnung eines Cloud-Dienstes ist nur ein Teil der Gesamtkosten. Für eine belastbare Kalkulation werden mindestens diese Blöcke getrennt:
- einmalige Prozessanalyse und Felddefinition
- Einrichtung oder Training von Klassifikation und Extraktion
- Entwicklung von Prüfregeln und Benutzeroberfläche
- Schnittstellen zu Posteingang, DMS, ERP, CRM oder Fachsystem
- laufende Seiten-, Modell- oder Rechenkosten
- Speicherung, Monitoring und Protokollierung
- menschliche Prüfung und Korrektur
- Pflege bei neuen Layouts, Feldern und Dokumenttypen
- Fehleranalyse und Wiederverarbeitung
Ein günstiger Seitenpreis hilft wenig, wenn jede zweite Datei nachbearbeitet werden muss. Umgekehrt kann eine höhere technische Verarbeitung wirtschaftlich sein, wenn sie riskante Felder mit Fundstelle vorbereitet und die Prüfzeit deutlich reduziert.
Der Automatisierungs-Rechner im Artikel unterstützt eine erste Potenzialabschätzung. Für eine Projektentscheidung sollten reale Mengen, heutige Bearbeitungszeit, Fehlerfolgen und verbleibende Kontrollarbeit aus einem begrenzten Zeitraum gemessen werden.
Welche Kennzahlen eine produktive Lösung braucht
Die reine Zahl verarbeiteter Seiten sagt wenig über die fachliche Qualität aus. Sinnvolle Kennzahlen sind:
Automatisierungs-Potenzial
Wie viel Zeit und Geld steckt in manuellen Prozessen?
- Stunden-Einsparung pro Woche
- Kosten-Einsparung in €/Jahr
- ROI-Zeitraum berechnet
- Ergebnis per E-Mail
- Anteil korrekt klassifizierter Dokumente
- Vollständigkeit je Pflichtfeld
- Genauigkeit je Feld und Dokumenttyp
- Anteil automatisch validierter Werte
- Anteil und Ursache manueller Prüfungen
- Korrekturzeit pro Dokument
- Durchlaufzeit vom Eingang bis zum Zielsystem
- technische Fehler und erfolgreiche Wiederholungen
- Dubletten und falsch zugeordnete Vorgänge
- fachliche Rückläufer nach der Übergabe
Kennzahlen werden nach Dokumenttyp, Quelle und Lieferant oder Formularversion aufgeteilt. Sonst verdeckt ein großer Bestand einfacher PDF-Rechnungen die Fehler eines kleinen, aber risikoreichen Vertragsprozesses.
Praxisbeispiel: Gemischter Dokumenteneingang eines technischen Dienstleisters
Das folgende Beispiel ist hypothetisch. Ein technischer Dienstleister erhält Eingangsrechnungen, Wartungsprotokolle und Serviceformulare über ein gemeinsames Postfach. Mitarbeiter speichern Anhänge in Ordnern, benennen sie um und übertragen Vorgangsnummern in verschiedene Systeme.
Der Pilot startet nur mit Wartungsprotokollen eines klar abgegrenzten Gerätetyps. Die Pipeline übernimmt Anhänge, prüft Lesbarkeit, klassifiziert das Dokument und extrahiert Gerät, Standort, Wartungsdatum, Techniker, Ergebnis und offene Maßnahme. Gerät und Standort werden gegen den Anlagenstamm geprüft.
Ein vollständig bestätigtes Protokoll wird dem Anlagenvorgang im DMS zugeordnet. Fehlt die Gerätenummer oder widerspricht das Wartungsdatum dem Einsatz, öffnet sich eine Prüfaufgabe mit Originalausschnitt. Offene Maßnahmen erzeugen erst nach Bestätigung ein Serviceticket.
Rechnungen und Verträge bleiben während des Piloten im bestehenden Prozess. Dadurch lassen sich Feldgenauigkeit, Korrekturzeit und Systemübergabe bewerten, ohne gleichzeitig drei fachlich unterschiedliche Fehlerklassen einzuführen.
Einführung in acht belastbaren Schritten
1. Einen Dokumenttyp und einen Abschluss wählen
Der Pilot braucht einen messbaren Endzustand, beispielsweise „Wartungsprotokoll korrekt im Anlagenvorgang abgelegt“.
2. Reale Varianten sammeln
Gute, schlechte, mehrseitige und abweichende Dokumente gehören in den Testbestand. Personenbezogene Testdaten werden geschützt oder ersetzt.
3. Zielfelder und Fundstellen definieren
Fachabteilung und Technik legen gemeinsam fest, was benötigt wird und woran ein Prüfer die Aussage im Original erkennt.
4. Risiken je Feld festlegen
Automatische Übernahme, Stammdatenprüfung, manuelle Freigabe und Abbruch werden vor der Entwicklung entschieden.
5. Komponenten auswählen
OCR, Layout, Extraktor, Sprachmodell und Regelwerk werden nach Dokumentenvarianten und Zielsystem gewählt. Die offizielle Amazon-Textract-Dokumentation zeigt beispielsweise, welche Analysearten für Text, Formulare, Tabellen, Abfragen und Signaturen verfügbar sind; andere Plattformen besitzen abweichende Modelle und Grenzen.
6. Prüfoberfläche und Schnittstellen bauen
Der Prüfer benötigt Originalausschnitt, Vorschlag, Regelverletzung und Zielaktion in einer Ansicht. Die KI-Integration und LLM-Entwicklung verbindet Modell, Regeln und Unternehmenssysteme zu diesem kontrollierten Ablauf.
7. Gegen einen Referenzbestand testen
Ergebnisse werden pro Feld und Dokumenttyp gegen fachlich bestätigte Sollwerte verglichen. Seltene, folgenschwere Fehler werden separat bewertet.
8. Begrenzt produktiv gehen
Ein Eingangskanal oder Dokumenttyp startet mit enger Kontrolle. Erst stabile Ergebnisse und beherrschte Ausnahmen rechtfertigen weitere Dokumentklassen.
Wann klassische Regeln oder manuelle Erfassung besser sind
KI ist nicht sinnvoll, wenn ein Lieferant bereits strukturierte Daten über E-Rechnung oder API liefert. In diesem Fall sollte das strukturierte Format direkt verarbeitet werden. Auch wenige gleichförmige Formulare lassen sich oft mit einer festen Vorlage günstiger auslesen.
Ein Projekt sollte außerdem warten, wenn:
- das Zielsystem keine eindeutigen Stammdaten enthält
- Dokumenttypen und Zuständigkeiten ungeklärt sind
- eine manuelle Entscheidung den größten Teil der Bearbeitung ausmacht
- keine ausreichenden Beispieldokumente verfügbar sind
- Fehler nicht erkannt oder zurückgerollt werden können
- sensible Unterlagen ohne geklärte Schutzmaßnahmen an externe Dienste gehen würden
Die beste Lösung kann eine Kombination sein: strukturierte Daten direkt übernehmen, OCR für Scans verwenden, ein Modell nur für variable Textstellen einsetzen und risikoreiche Felder kontrollieren.
Aus Dokumenten werden verlässliche Vorgänge
Nehmen Sie für eine erste Prüfung 30 bis 50 reale Dokumente eines Typs und markieren Sie die Felder, die ein Mitarbeiter heute tatsächlich in ein anderes System überträgt. Ergänzen Sie pro Feld die Zielquelle, eine Prüfregel und die Folge eines Fehlers. Danach lässt sich belastbar entscheiden, ob OCR genügt, ein trainierter Extraktor benötigt wird oder ein Sprachmodell variable Inhalte einordnen soll.
SW Business Solutions entwickelt KI-gestützte Dokumentenprozesse von der Analyse über Extraktionsschema und Prüfoberfläche bis zur DMS-, ERP- und CRM-Integration. Das Ziel ist kein beeindruckender Demo-Upload, sondern ein dokumentierter Vorgang: mit Original, Fundstellen, bestätigten Werten, klaren Ausnahmen und einer sicheren Übergabe an das System, in dem die weitere Arbeit stattfindet.
Häufige Fragen
Was ist KI-gestützte Dokumentenverarbeitung?
Was ist der Unterschied zwischen OCR und KI-Dokumentenverarbeitung?
Welche Dokumente lassen sich mit KI auslesen?
Kann KI Verträge automatisch prüfen?
Wie werden fehlerhaft erkannte Felder verhindert?
Muss jedes ausgelesene Dokument manuell geprüft werden?
Wie wird KI-Dokumentenverarbeitung an ERP oder DMS angebunden?
Was kostet eine KI-Lösung zur Dokumentenverarbeitung?
Wann lohnt sich KI für Dokumente nicht?
Verwendete Technologien


Passende Leistungen
Beratung & Planung
Technische Beratung, Workshops und Requirements Engineering für Ihre Projekte. Wir unterstützen Sie bei der Planung und Umsetzung Ihrer digitalen Strategie.
Softwarearchitektur
Fundierte Architekturentscheidungen als Grundlage für skalierbare, wartbare und sichere Softwaresysteme.
API-Entwicklung
Entwicklung von RESTful APIs und GraphQL-Schnittstellen für die Integration verschiedener Systeme. Wir schaffen flexible und dokumentierte Schnittstellen für Ihre Anwendungen.
KI-Integration & LLM
Integration von Künstlicher Intelligenz und Large Language Models in Ihre bestehenden Systeme und Geschäftsprozesse.